Локальная нейросеть: Ollama + Open WebUI на своём сервере
Свой ChatGPT без облака: Ollama запускает модели на вашем сервере, Open WebUI даёт привычный чат. Установка, выбор модели под железо и главное — как не выставить нейросеть в интернет.
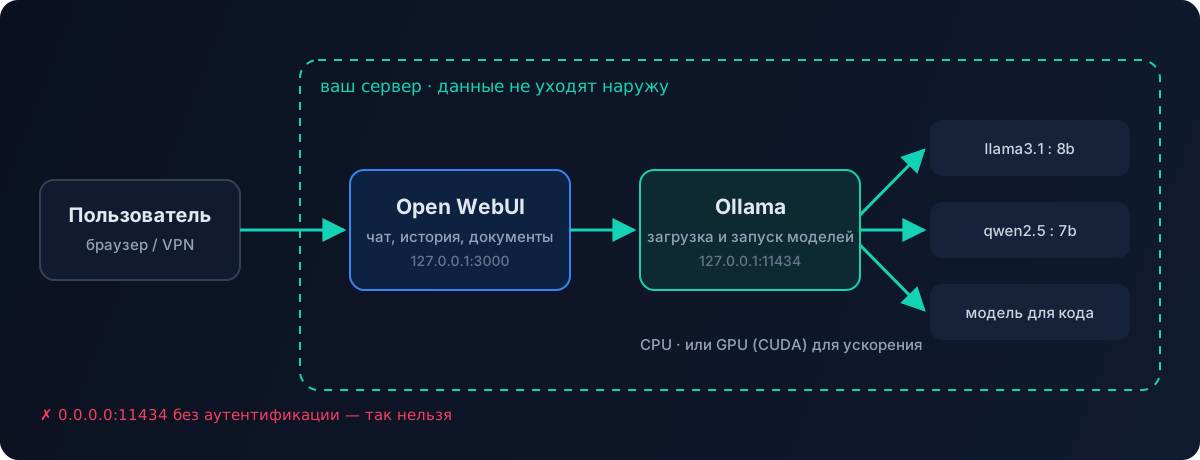
Облачные модели удобны, но в ИБ постоянно работаешь с тем, что нельзя отправлять наружу: логи, конфиги, данные клиентов, результаты аудитов. Для таких задач я держу локальную нейросеть: модель крутится на своём сервере, и ни один байт не уходит к стороннему провайдеру. Связка простая — Ollama запускает модели, Open WebUI даёт веб-интерфейс как у ChatGPT.
Требования к железу
| Что | Минимум |
|---|---|
| ОС | Linux, например Ubuntu 22.04+ |
| Оперативная память | ~16 ГБ для моделей размером 7–8B |
| Диск | от 12 ГБ: Ollama и пара базовых моделей, дальше — по размеру моделей |
| Процессор | 4+ ядра, для моделей 13B — от 8 ядер |
| GPU | не обязателен, но сильно ускоряет генерацию |
Ориентир простой: квантованная модель на 7–8 миллиардов параметров занимает несколько гигабайт и нормально работает даже на CPU. Модели 30B+ без видеокарты с достаточной видеопамятью будут отвечать очень медленно. Если планируете GPU — сначала поставьте драйверы NVIDIA и CUDA.
Установка Ollama
Официальный скрипт ставит бинарник и сервис:
curl -fsSL https://ollama.com/install.sh | sh
Если нужен свой контроль над сервисом — отдельный пользователь и unit-файл:
sudo useradd -r -s /bin/false -m -d /usr/share/ollama ollama
# /etc/systemd/system/ollama.service
[Unit]
Description=Ollama Service
After=network-online.target

[Service]
ExecStart=/usr/local/bin/ollama serve
User=ollama
Group=ollama
Restart=always
RestartSec=3
Environment="OLLAMA_HOST=127.0.0.1:11434"
# Для видеокарт NVIDIA — ускорение генерации:
# Environment="OLLAMA_FLASH_ATTENTION=1"

[Install]
WantedBy=default.target
sudo systemctl daemon-reload
sudo systemctl enable --now ollama
ollama --version
Модели
ollama pull llama3.1:8b     # универсальная модель
ollama pull qwen2.5:7b      # хорошо работает с русским и кодом
ollama list                 # что скачано
ollama run llama3.1:8b      # чат прямо в терминале
Как выбирать:
- под задачу — для кода и конфигов берите модели, заточенные под код; для текстов на русском — модели с хорошей мультиязычностью;
- под железо — сначала 7–8B, и только если скорость устраивает, пробуйте больше;
- квантование — версии
q4/q5в разы меньше по памяти при небольшой потере качества.
Каталог моделей — на сайте Ollama, там же указан размер каждой версии.
Open WebUI
Самый быстрый способ — Docker-образ, в который Ollama уже встроена:
# с GPU
docker run -d -p 127.0.0.1:3000:8080 --gpus=all \
  -v ollama:/root/.ollama -v open-webui:/app/backend/data \
  --name open-webui --restart always ghcr.io/open-webui/open-webui:ollama

# только CPU
docker run -d -p 127.0.0.1:3000:8080 \
  -v ollama:/root/.ollama -v open-webui:/app/backend/data \
  --name open-webui --restart always ghcr.io/open-webui/open-webui:ollama
Если Ollama уже стоит как сервис, используйте обычный образ open-webui:main и укажите ему адрес Ollama через переменную OLLAMA_BASE_URL.
Интерфейс откроется на http://127.0.0.1:3000. Первый зарегистрированный пользователь становится администратором — зарегистрируйтесь сразу после запуска.
Что умеет Open WebUI помимо чата: история диалогов, несколько моделей, загрузка документов для вопросов по ним, пользователи и роли.
Безопасность — самое важное
В интернете полно инструкций, где Ollama запускают с OLLAMA_HOST=0.0.0.0 и OLLAMA_ORIGINS=*. Так делать не стоит:
- API Ollama не имеет аутентификации. Если порт
11434открыт наружу, любой может пользоваться вашим сервером, скачивать и удалять модели. Открытые инстансы Ollama массово находят сканерами. - Слушайте только localhost или внутренний адрес за VPN. Если доступ нужен по сети — ставьте обратный прокси с TLS и аутентификацией, а порт закройте файрволом.
- Open WebUI публикуйте тоже только через прокси с TLS и отключите свободную регистрацию после создания своих пользователей.
OLLAMA_ORIGINS=*разрешает обращаться к API из любого сайта в браузере — без необходимости не включайте.
Проверка, что наружу ничего не торчит:
ss -tlnp | grep -E '11434|3000'
Оба порта должны слушать 127.0.0.1, а не 0.0.0.0.
Где я это использую
- разбор логов и конфигов, которые нельзя отправлять в облако;
- черновики документации и инструкций по внутренней базе знаний;
- эксперименты с агентами — локальная модель как «бесплатный» исполнитель простых задач.
Для сложных задач облачные модели пока сильнее, поэтому я комбинирую: локальная модель для приватного и рутинного, облачная — для тяжёлого анализа. Как я выбираю модели и считаю деньги, рассказываю в статье «Как экономить на AI-агентах».