Кейс: сайт падает при сохранении новости — разбор от Apache до MySQL
Каждый раз, когда редактор сохранял новость, сервер уходил в штопор: сотни процессов Apache, 504 и только жёсткая перезагрузка. Разработчики CMS ответили «это не к нам». Рассказываю, как шли по цепочке от nginx до MySQL и что в итоге помогло.
Это мой первый разобранный кейс по производительности — с него, по сути, и начался этот блог. Клиент заказал платные административные работы на своём облачном сервере. Все данные обезличены: названия сайта, сервера и базы изменены.
Исходные данные
| Параметр | Значение |
|---|---|
| Сервер | облачный VPS, 2 vCPU, 8 ГБ RAM |
| ОС | Ubuntu 22.04 |
| Панель | ISPmanager |
| Стек | nginx → Apache (prefork) → PHP → MySQL 8 |
| Кэш | Redis, OPcache |
| Сайт | новостной портал на DLE, десятки тысяч публикаций с аудио |
Жалоба клиента: в момент сохранения новости резко растёт число процессов, CPU и память уходят в потолок, сайт отдаёт 504 Gateway Time-Out, помогает только принудительная перезагрузка.
Клиент сначала обратился к разработчикам CMS. Ответ был логичным, но бесполезным: «при сохранении DLE сбрасывает свои кэши, нагрузка растёт, а настройка сервера — это к хостингу». Так задача пришла ко мне.
Шаг 1. Воспроизвести проблему
Без воспроизведения можно бесконечно крутить настройки вслепую. Я попросил клиента создать тестовую новость и передать файлы, с которыми обычно работают редакторы. Результат: любое редактирование новости с аудио запускало лавину — число процессов Apache росло без остановки, пока сервер не зависал.
Теперь было что измерять.
Шаг 2. nginx: не хватает соединений
Первым в цепочке стоит nginx, с его логов и начал:
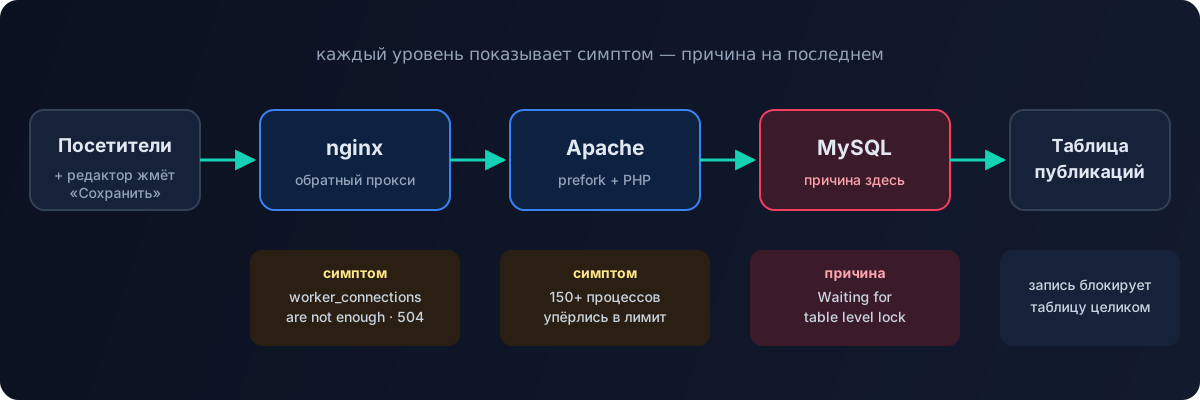
[alert] 768 worker_connections are not enough
Стандартных 768 соединений на воркер не хватало. Увеличил лимит и настроил буферизацию ответов от бэкенда:
events {
    worker_connections 4096;
}

# в блоке http / server
proxy_buffering on;
proxy_buffer_size 4k;
proxy_buffers 32 4k;
proxy_max_temp_file_size 0;
Ошибки ушли, но сайт всё равно ложился — nginx просто стал передавать затор дальше.
Шаг 3. Apache: процессы упираются в лимит
Следующий уровень — Apache в режиме prefork: каждый запрос занимает отдельный процесс. Клиент видел более 150 процессов apache2 — ровно столько, сколько разрешал лимит. Новые запросы вставали в очередь, nginx не дожидался ответа и отдавал 504.
Поднял лимиты в /etc/apache2/mods-available/mpm_prefork.conf:
StartServers            10
MinSpareServers         10
MaxSpareServers         20
ServerLimit             2000
MaxRequestWorkers       1500
MaxConnectionsPerChild  10000
MaxConnectionsPerChild перезапускает процесс после 10 000 запросов — это защищает от утечек памяти в PHP.
После этого процессы перестали упираться в потолок, и вся нагрузка переехала на базу данных. Это важный момент: поднятие лимитов не решает проблему, а переносит её на следующий уровень. Зато теперь было видно, где она на самом деле.
Шаг 4. MySQL: очередь из блокировок
SHOW PROCESSLIST показал картину, которая объяснила всё:
| Id   | db     | Command | Time | State                        | Info                          |
| 6294 | site_db | Query  |   46 | Waiting for table level lock | SELECT p.id, p.autor, ... |
| 6295 | site_db | Query  |   29 | Waiting for table level lock | SELECT p.id, p.autor, ... |
| 6296 | site_db | Query  |   26 | Waiting for table level lock | SELECT p.id, p.autor, ... |
| 6303 | site_db | Query  |   73 | executing                    | SELECT p.id, p.autor, ... |
...
Десятки одинаковых SELECT к таблице публикаций висят в состоянии Waiting for table level lock по 30–70 секунд. Механика затора:
- Редактор сохраняет новость — CMS пишет в таблицу публикаций и сбрасывает свой кэш.
- Запись блокирует таблицу целиком.
- Кэш сброшен, поэтому каждый посетитель сайта идёт прямо в базу — и встаёт в очередь за блокировкой.
- Каждый ждущий запрос держит процесс Apache — процессы плодятся, память кончается, сервер падает.
Чтобы понять, какие запросы виноваты, включил лог медленных запросов и разобрал его утилитой pt-query-digest из Percona Toolkit:
# Overall: 811 total, 23 unique, 1.08 QPS, 88.99x concurrency
# Attribute          total     min     max     avg     95%
# Exec time         66652s      2s    168s     82s    159s
# Lock time         44917s       0    159s     55s    151s

# Rank Response time     Calls R/Call   Item
#    1 31009.2  46.5%      282 109.96   SELECT dle_post dle_post_extras
#    2 18449.6  27.7%      167 110.48   SELECT dle_post dle_post_extras dle_post_extras_cats
#    3  7528.1  11.3%       93  80.95   SELECT dle_post dle_post_extras_cats dle_post_extras
Ключевые цифры: средний запрос выполнялся 82 секунды, из них 55 секунд — ожидание блокировки. Конкурентность 89x означает, что одновременно в очереди стояло около 90 запросов. Проблема была не в «тяжёлых» запросах, а в том, что они ждали друг друга.
Шаг 5. Конфигурация MySQL
Конфиг MySQL был почти стандартным, рассчитанным на минимальное железо. Привёл его в соответствие с сервером на 8 ГБ, где база — главный потребитель памяти:
[mysqld]
# InnoDB: данные и индексы — в памяти
innodb_buffer_pool_size      = 4G
innodb_buffer_pool_instances = 4
innodb_log_file_size         = 1G
innodb_flush_method          = O_DIRECT
innodb_read_io_threads       = 8
innodb_write_io_threads      = 8
innodb_lock_wait_timeout     = 50

# Кэши и буферы
key_buffer_size    = 64M
table_open_cache   = 2000
sort_buffer_size   = 4M
thread_cache_size  = 100

# Соединения
max_connections     = 300
wait_timeout        = 120
interactive_timeout = 120

# Диагностика
slow_query_log                = 1
slow_query_log_file           = /var/log/mysql/mysql-slow.log
long_query_time               = 1
log_queries_not_using_indexes = 1
Что здесь главное:
| Параметр | Зачем |
|---|---|
innodb_buffer_pool_size = 4G | половина RAM под кэш данных и индексов: запросы читают из памяти, а не с диска |
innodb_flush_method = O_DIRECT | нет двойного кэширования в InnoDB и в кэше ОС |
innodb_log_file_size = 1G | реже сбросы журнала при записи |
table_open_cache, thread_cache_size | меньше накладных расходов на открытие таблиц и создание потоков |
max_connections = 300 | лимит, согласованный с памятью: каждое соединение тоже ест RAM |
slow_query_log | постоянный мониторинг, чтобы следующая проблема была видна сразу |
Попутно из конфига убрал параметры query_cache_* — в MySQL 8 query cache удалён, и такие строки мешают серверу стартовать.
Результат
После изменений лавина при сохранении новости исчезла. SHOW PROCESSLIST в момент редактирования — несколько спящих служебных соединений и ни одного ожидания блокировки. Повторный разбор медленного лога:
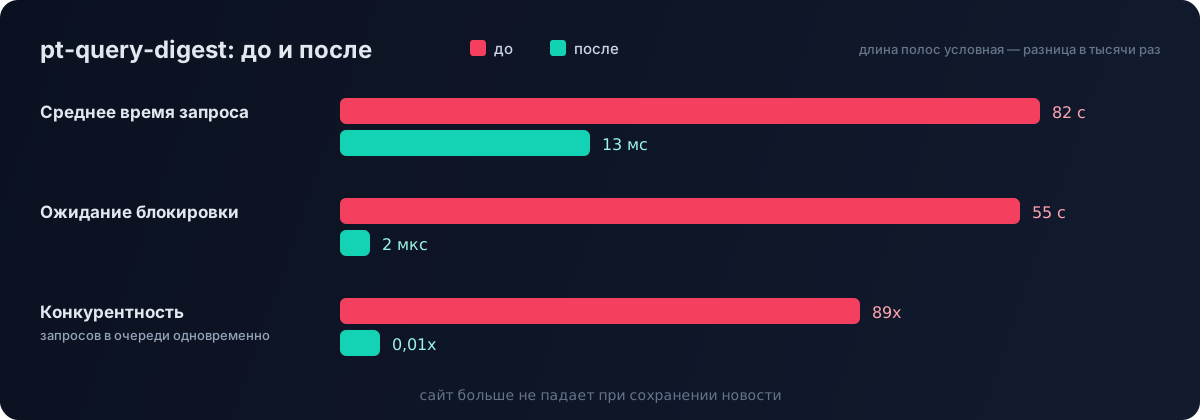
| Метрика | До | После |
|---|---|---|
| Среднее время запроса | 82 с | 13 мс |
| Среднее ожидание блокировки | 55 с | 2 мкс |
| Конкурентность | 89x | 0,01x |
| Запросов в медленном логе за ~10 минут | 811 | 278 |
Большая часть запросов теперь выполняется за 100 мкс – 1 мс. Медленные запросы остались — например, выборка с NOT IN (подзапрос) и сортировкой по счётчику просмотров, которая просматривает 228 тысяч строк, — но они больше не блокируют весь сайт.
Что я сделал бы иначе сегодня
Это был мой первый серьёзный разбор производительности. Перечитывая его спустя время, вижу, что можно было сделать лучше:
Сразу проверить движок таблиц.
Waiting for table level lock— классический признак таблиц MyISAM: они блокируются целиком на любую запись. InnoDB блокирует только нужные строки. Проверка занимает одну команду:SELECT TABLE_NAME, ENGINE FROM information_schema.TABLES WHERE TABLE_SCHEMA = 'site_db' AND ENGINE <> 'InnoDB';Перевод старых таблиц на InnoDB (
ALTER TABLE … ENGINE=InnoDB, после бэкапа) решает именно эту причину, а не её симптомы.Осторожнее с лимитами Apache.
MaxRequestWorkers 1500на сервере с 8 ГБ — это ставка на то, что процессы будут лёгкими. Один процесс prefork с PHP занимает десятки мегабайт, и при новом заторе такой лимит может съесть всю память. Правильнее считать лимит от памяти, а ещё лучше — перейти на PHP-FPM иmpm_event.Не забывать про кэш приложения. Затор начинался с того, что после сохранения новости все посетители одновременно шли в базу. Кэширование страниц на уровне nginx или Redis сглаживает такие всплески.
Добавить индексы под медленные запросы. Оставшиеся медленные выборки — кандидаты на индекс и разбор через
EXPLAIN.
Выводы
- Сначала воспроизвести, потом настраивать. Тестовая новость от клиента сэкономила дни догадок.
- Идти по цепочке запроса. nginx → Apache → PHP → MySQL: каждый уровень показывает симптом, причина — на последнем.
- Поднятие лимитов переносит проблему, а не решает её. Зато показывает, где настоящее узкое место.
- Метрики до и после. Без
pt-query-digest«стало лучше» было бы просто ощущением.
Похожие проблемы хостинга — переполненные логи, почтовые очереди, зависшие задачи — я собрал в шпаргалке по Plesk.