Qyran: как я построил свою платформу для bug bounty и аудита с ИИ
От Bash-скрипта до платформы на ~150 тысяч строк кода: почему ручная разведка не масштабируется, как база знаний за десять лет превратилась в 120+ навыков для ИИ и как устроены конвейер разведки, прокси, оценка целей и автономные AI-агенты.
Qyran (каз. Қыран — беркут) — моя self-hosted платформа для bug bounty и аудита безопасности. Она собирает десятки инструментов разведки и сканирования в один процесс, хранит всё в общей базе, показывает результаты в удобной панели и подключает AI-агентов там, где нужен анализ. В этой статье — зачем она появилась, через какие попытки я к ней пришёл и как она устроена изнутри.
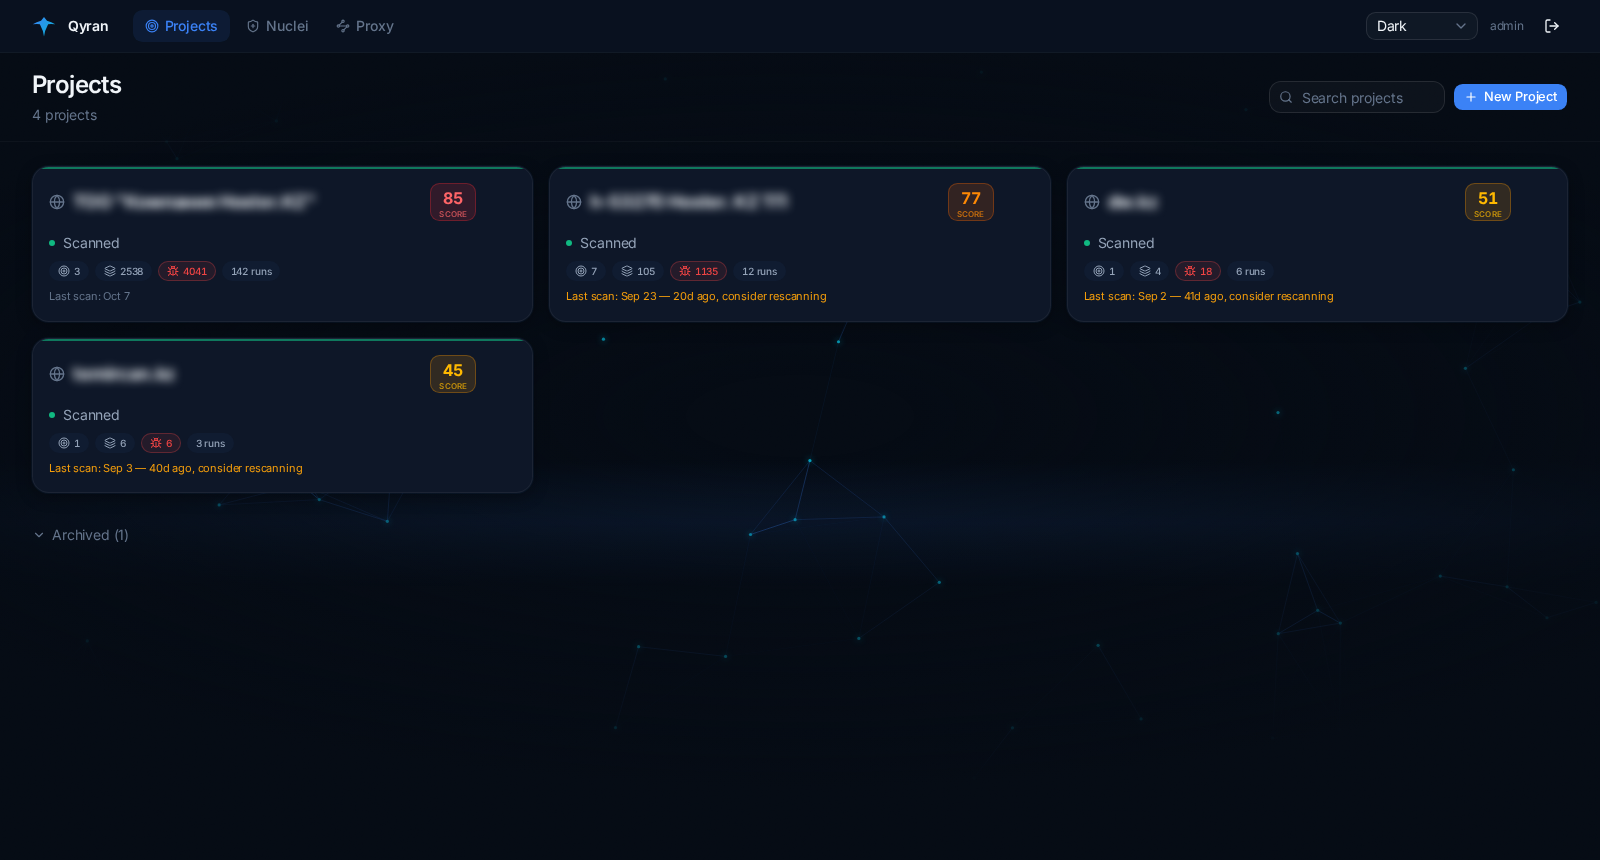
Код проекта закрыт. Все скриншоты сделаны на реальных данных и обезличены: имена целей, домены, IP-адреса и превью страниц размыты.
Проблема: разведка руками не масштабируется
Классическая разведка и аудит — это:
- десятки инструментов —
subfinder,httpx,nmap,ffuf,nuclei, OpenVAS, OWASP ZAP и многие другие, каждый под свою задачу; - разные форматы вывода — одни находят то, что не находят другие, часть результатов дублируется;
- ручная агрегация — объединять, чистить и сравнивать результаты приходится часами;
- риск забыть — из-за количества инструментов, аргументов и форматов легко пропустить проверку или потерять важную находку.
Для этого есть готовые платформы, но серьёзные решения вроде Faraday относятся к enterprise-сегменту и стоят дорого. Для одного исследователя или небольшой команды это неподъёмно.
Мой путь к панели
Мой путь в offensive security — bug bounty, Hack The Box, лаборатории PortSwigger, челленджи на Root-Me и собственная база знаний в Obsidian. За годы в ней накопились тысячи заметок: техники атак, разборы уязвимостей, чеклисты разведки, вордлисты.
Первая попытка — ReconWTF
Первой попыткой автоматизации был ReconWTF — Bash-фреймворк, который запускал 30+ инструментов по цепочке. Он работал, но упёрся в потолок:
- результаты — текстовые файлы, которые всё равно нужно разбирать руками;
- нет базы данных, истории и сравнения между запусками;
- Bash плохо масштабируется — поддерживать и развивать его стало тяжело.
Проект я заархивировал и начал думать о полноценной панели.
Поворотный момент — ИИ
Решение делать панель пришло, когда я взял из своей базы знаний методику поиска XSS, оформил её как навык (skill) для ИИ-агента и направил на лабораторию PortSwigger. Агент нашёл все уязвимости лаборатории за несколько минут — вручную на это могли уйти часы.
Главное открытие было даже не в скорости: база знаний, которую я собирал почти десять лет, наконец начала работать как инструмент. Из заметок получились не короткие подсказки, а полноценные playbook’и: деревья решений, правила безопасной работы, чеклисты, payload’ы, ветки обхода WAF, требования к доказательствам и отчёту, маршрутизация между классами уязвимостей.
Стало понятно: если таких навыков будет много, а данные разведки будут лежать в одной базе, получится фреймворк для автоматизированного поиска и анализа уязвимостей.
Философия: код — для рутины, ИИ — для анализа
Главный принцип Qyran:
Всё, что можно сделать кодом, программируется. ИИ занимается тем, где нужен анализ и творческий подход.
ИИ — важный компонент, но не единственный и не основной. Разведка, сканирование, дедупликация, сравнение с прошлыми запусками и оценка активов — это детерминированный код. ИИ получает уже подготовленные данные и решает задачи, где нужна гибкость: проверить гипотезу, разобрать бизнес-логику, связать находки в цепочку.
Это ещё и вопрос денег. Подписки на топовые модели стоят порядка $200 в месяц. Ядро AI-слоя построено на opencode, который позволяет подключать разных провайдеров моделей и выбирать вариант по цене и качеству. По моим тестам выгоднее всего оказалась одна из моделей DeepSeek — одно полное сканирование обходится примерно в доллар.
Полный цикл проверки
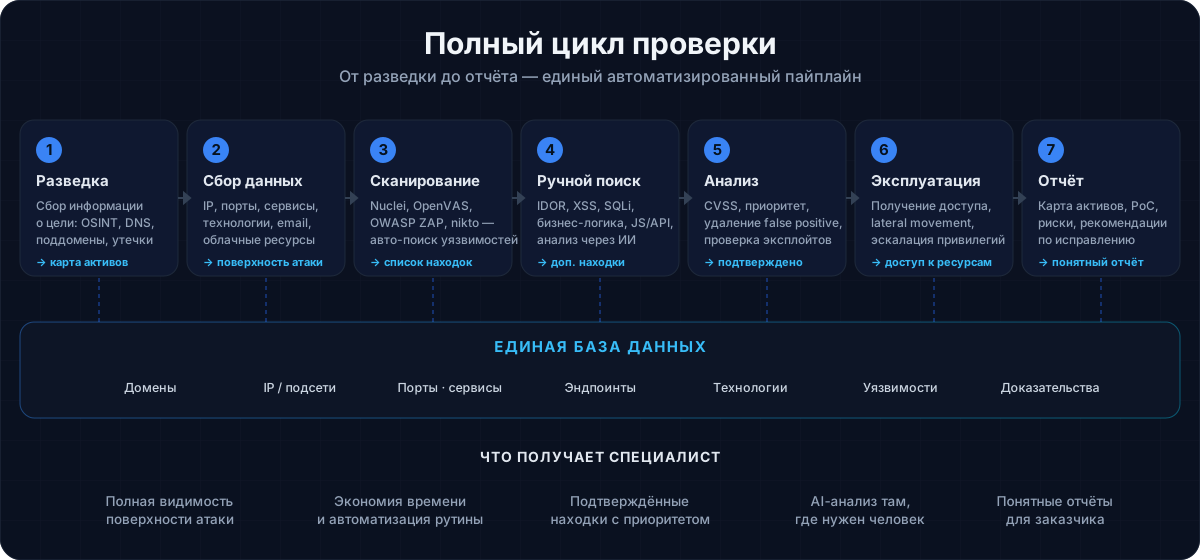
На вход загружаются известные цели — домены, поддомены, IP-адреса и диапазоны — и задаётся scope. Дальше остаётся ждать. Режимы запуска: разовый, раз в сутки или бесконечный мониторинг; отдельные этапы можно включать и отключать.
Архитектура
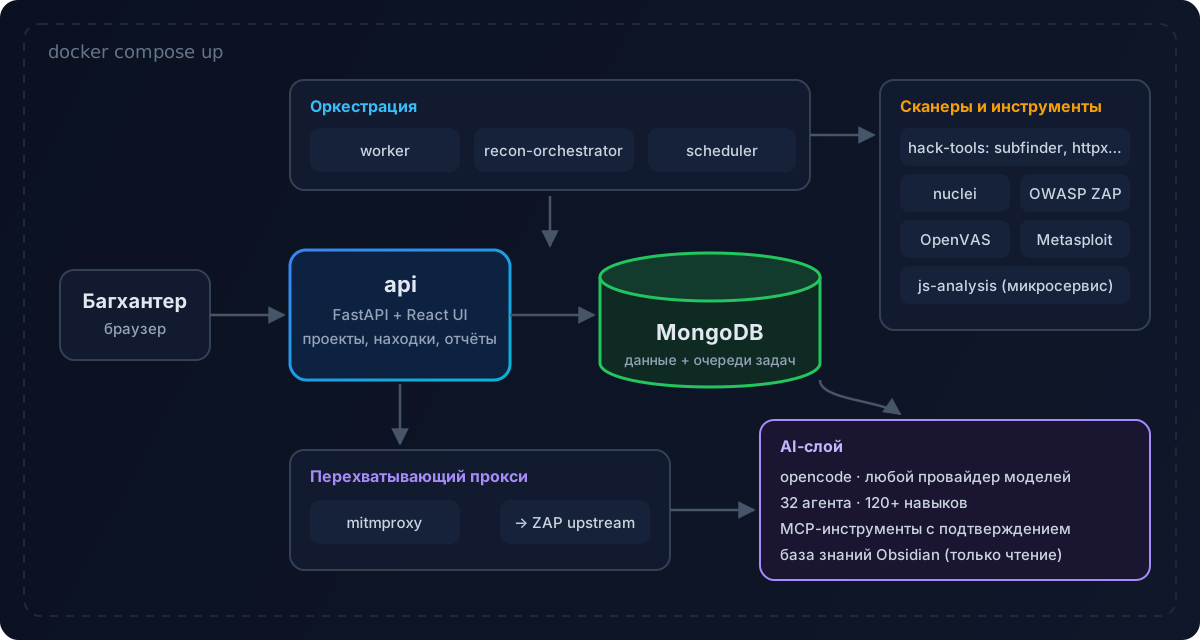
Всё поднимается одной командой через Docker Compose:
| Сервис | Роль |
|---|---|
api | FastAPI-бэкенд и собранный React-интерфейс |
worker, recon-orchestrator, recon-stage-dispatcher | оркестрация многостадийной разведки |
scheduler | периодические сканы и задачи |
mongodb | основное хранилище и очереди задач |
mitmproxy → zap | перехватывающий прокси и активное/пассивное сканирование |
openvas, hack-tools | сканер инфраструктуры и контейнер с CLI-утилитами |
js-analysis | отдельный микросервис анализа JavaScript |
Стек: Python 3.12, FastAPI, React + TypeScript + Vite + Tailwind, MongoDB, Docker Compose. Бэкенд — около 67 тысяч строк Python, весь проект — порядка 150 тысяч строк.
Интересное решение — без Redis и отдельного брокера. Очереди сделаны на коллекциях MongoDB с атомарным захватом задач: воркер одной операцией помечает задачу как свою, поэтому две копии воркера не возьмут одно и то же. Меньше сервисов — проще деплой.
Сердце панели: сигнальный конвейер разведки
Самая интересная часть под капотом — то, как устроена разведка. Это не линейный скрипт «шаг 1 → шаг 2 → шаг 3», а конвейер на сигналах.
Каждая стадия описана контрактом:
- какие сигналы она принимает на вход;
- какие сигналы производит на выходе;
- от каких стадий зависит;
- её приоритет.
hostname ──► dns_resolution ──► dns_resolved, ip
dns_resolved ──► http_liveness ──► live_origin
live_origin ──► full_http_metadata ──► technology, certificate
live_origin ──► crawl ──► endpoint, js_source
live_origin ──► proxy_capture ──► proxy_captured
live_origin ──► screenshot ──► screenshot_captured
ip ──► ports_services ──► port, service
hostname ──► historical_urls ──► endpoint, archive_js
endpoint, api_route, parameter ──► wordlist_refresh ──► wordlist_updated
Каждая новая находка — сигнал. Новый поддомен порождает задачу на DNS-резолв, резолв порождает проверку живости, живой хост — сбор метаданных, краулинг, скриншот и захват через прокси. Конвейер сам планирует, что делать дальше, исходя из того, что уже найдено. Внутри проекта такие циклы называются Ouroboros — змея, кусающая свой хвост: результаты одного цикла становятся входом следующего.
Почему это важно:
- никаких лишних проверок — стадия запускается только когда есть данные для неё;
- идемпотентность — одинаковые сигналы склеиваются, повторный запуск не плодит дубликаты;
- легко расширять — новая стадия описывается контрактом и автоматически встраивается в граф;
- бесконечный режим — конвейер может работать постоянно, реагируя на изменения у цели.
Разделы панели
Overview — сводка по цели
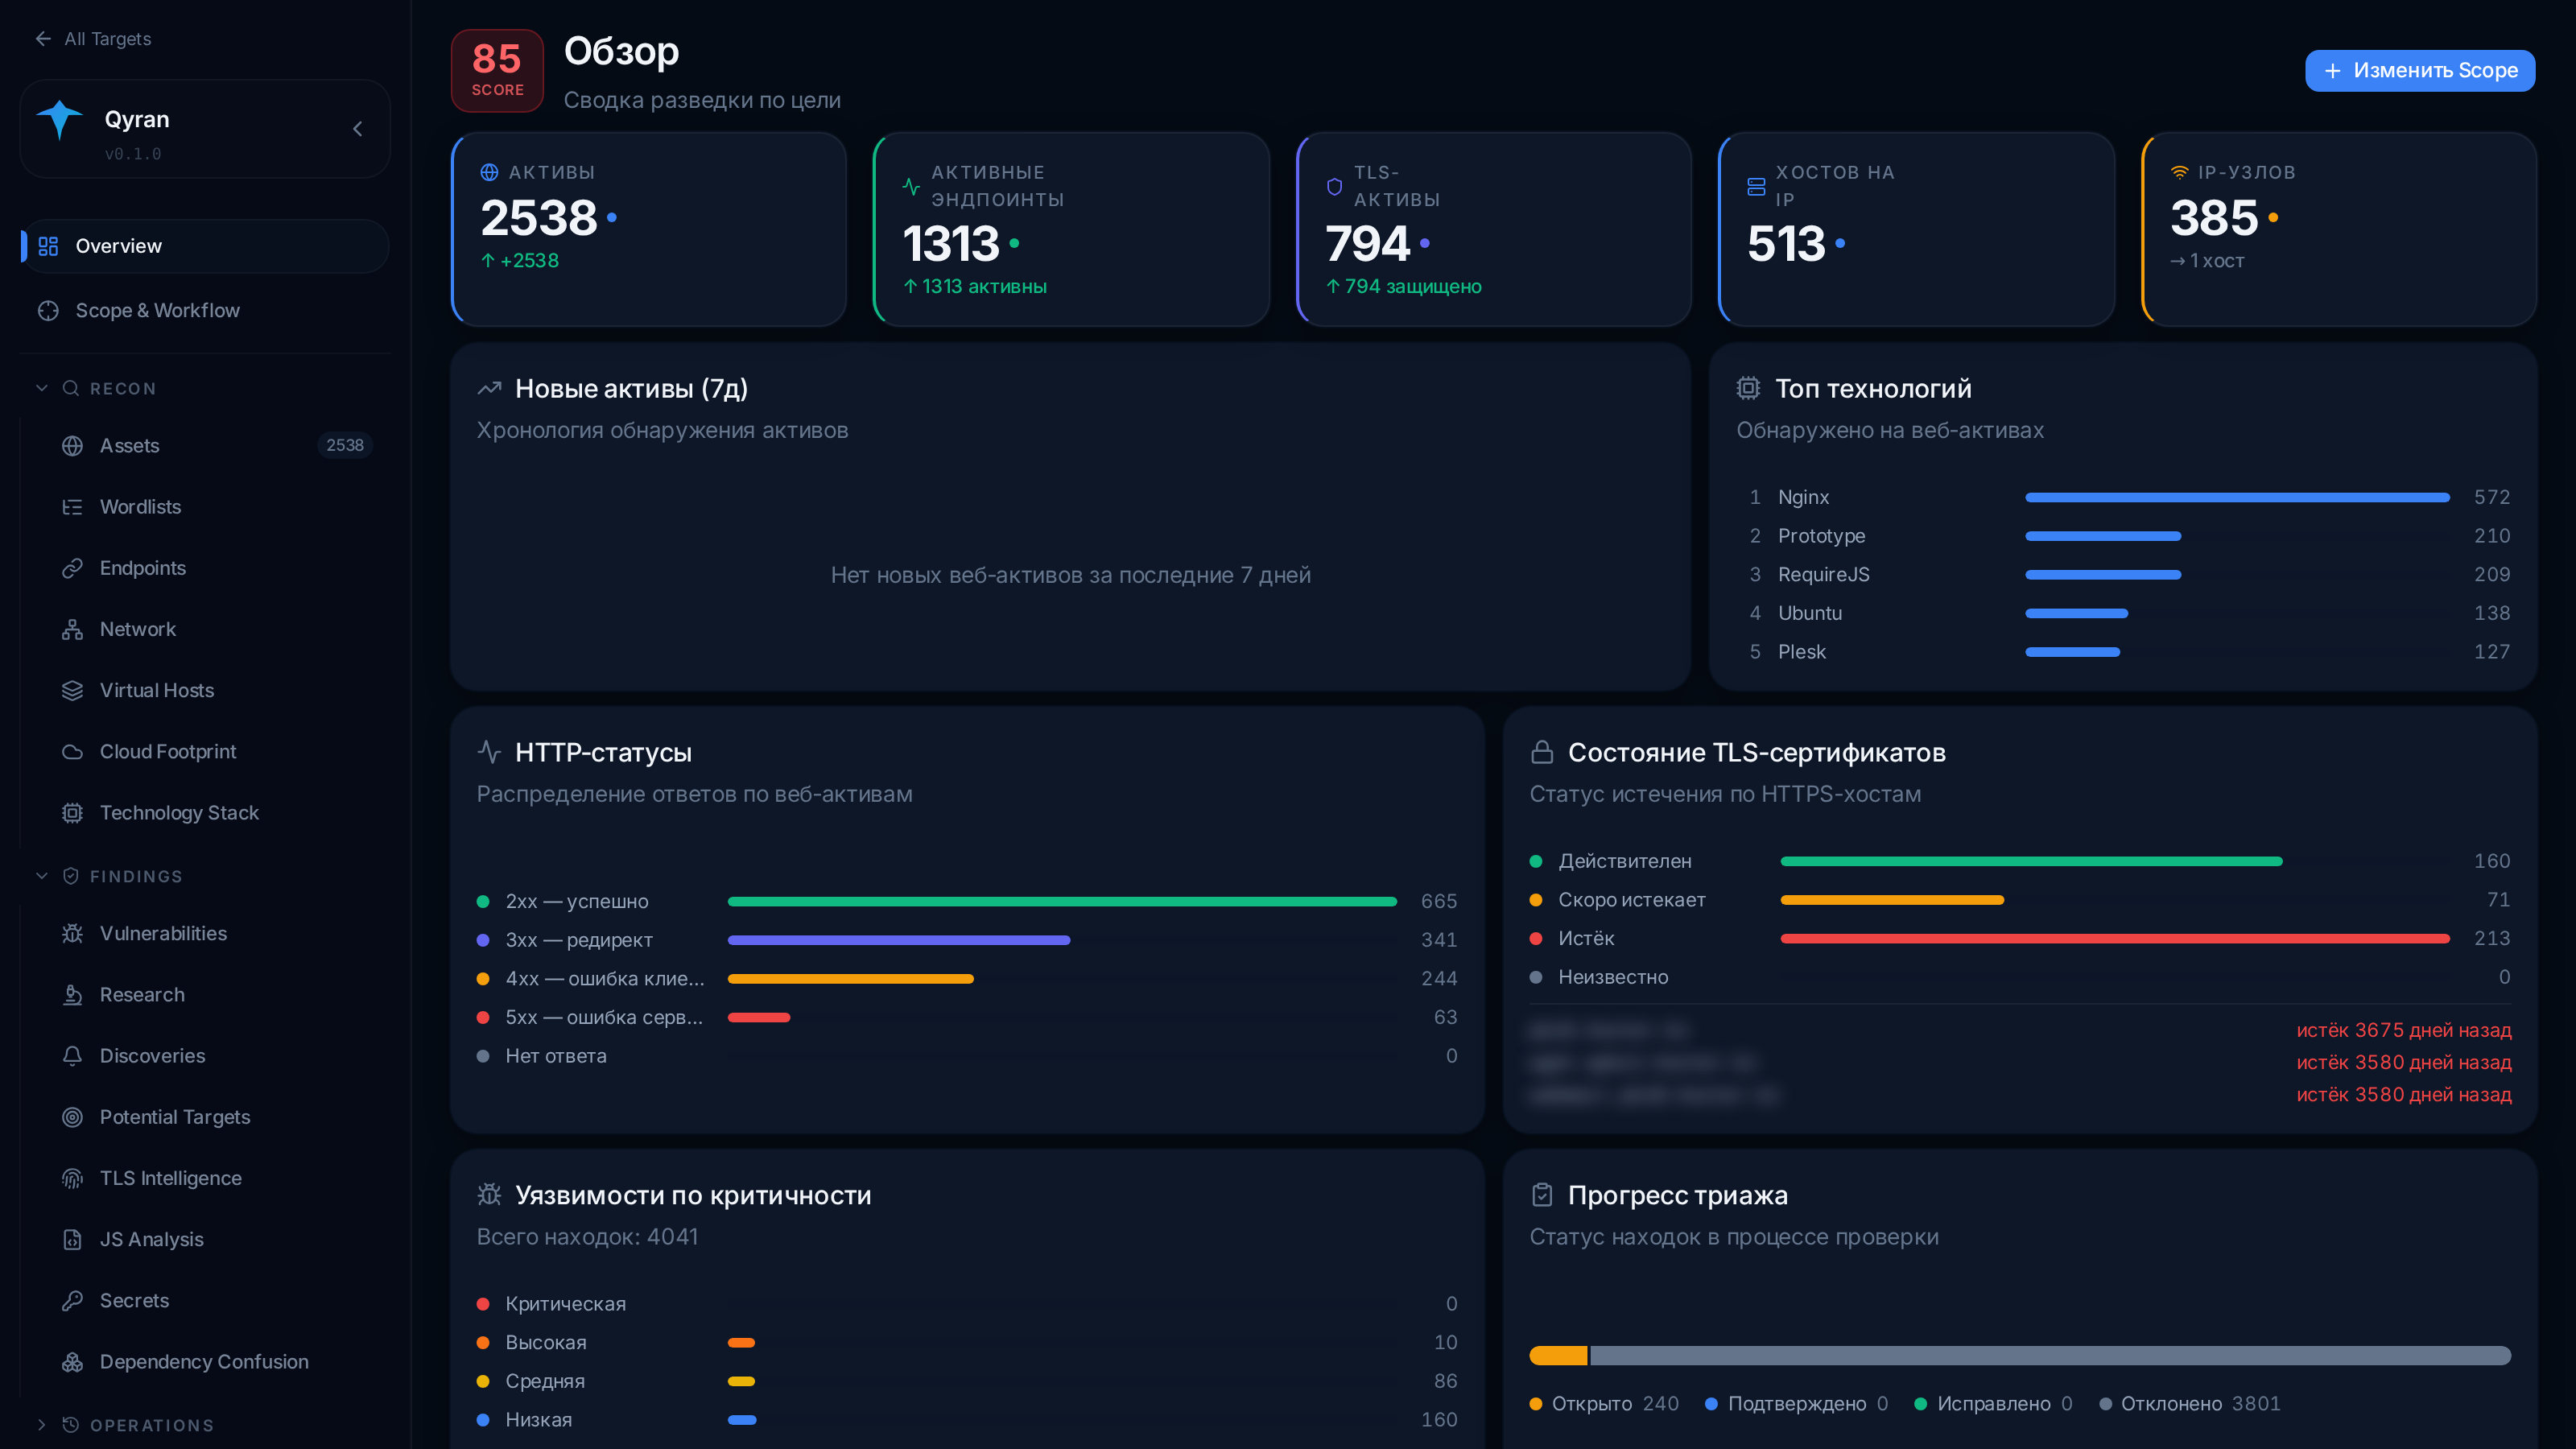
На одном экране — сколько активов и живых эндпоинтов, топ технологий, распределение HTTP-статусов, состояние TLS-сертификатов (в том числе давно истёкших), уязвимости по критичности и прогресс триажа.
Assets — обозреватель активов
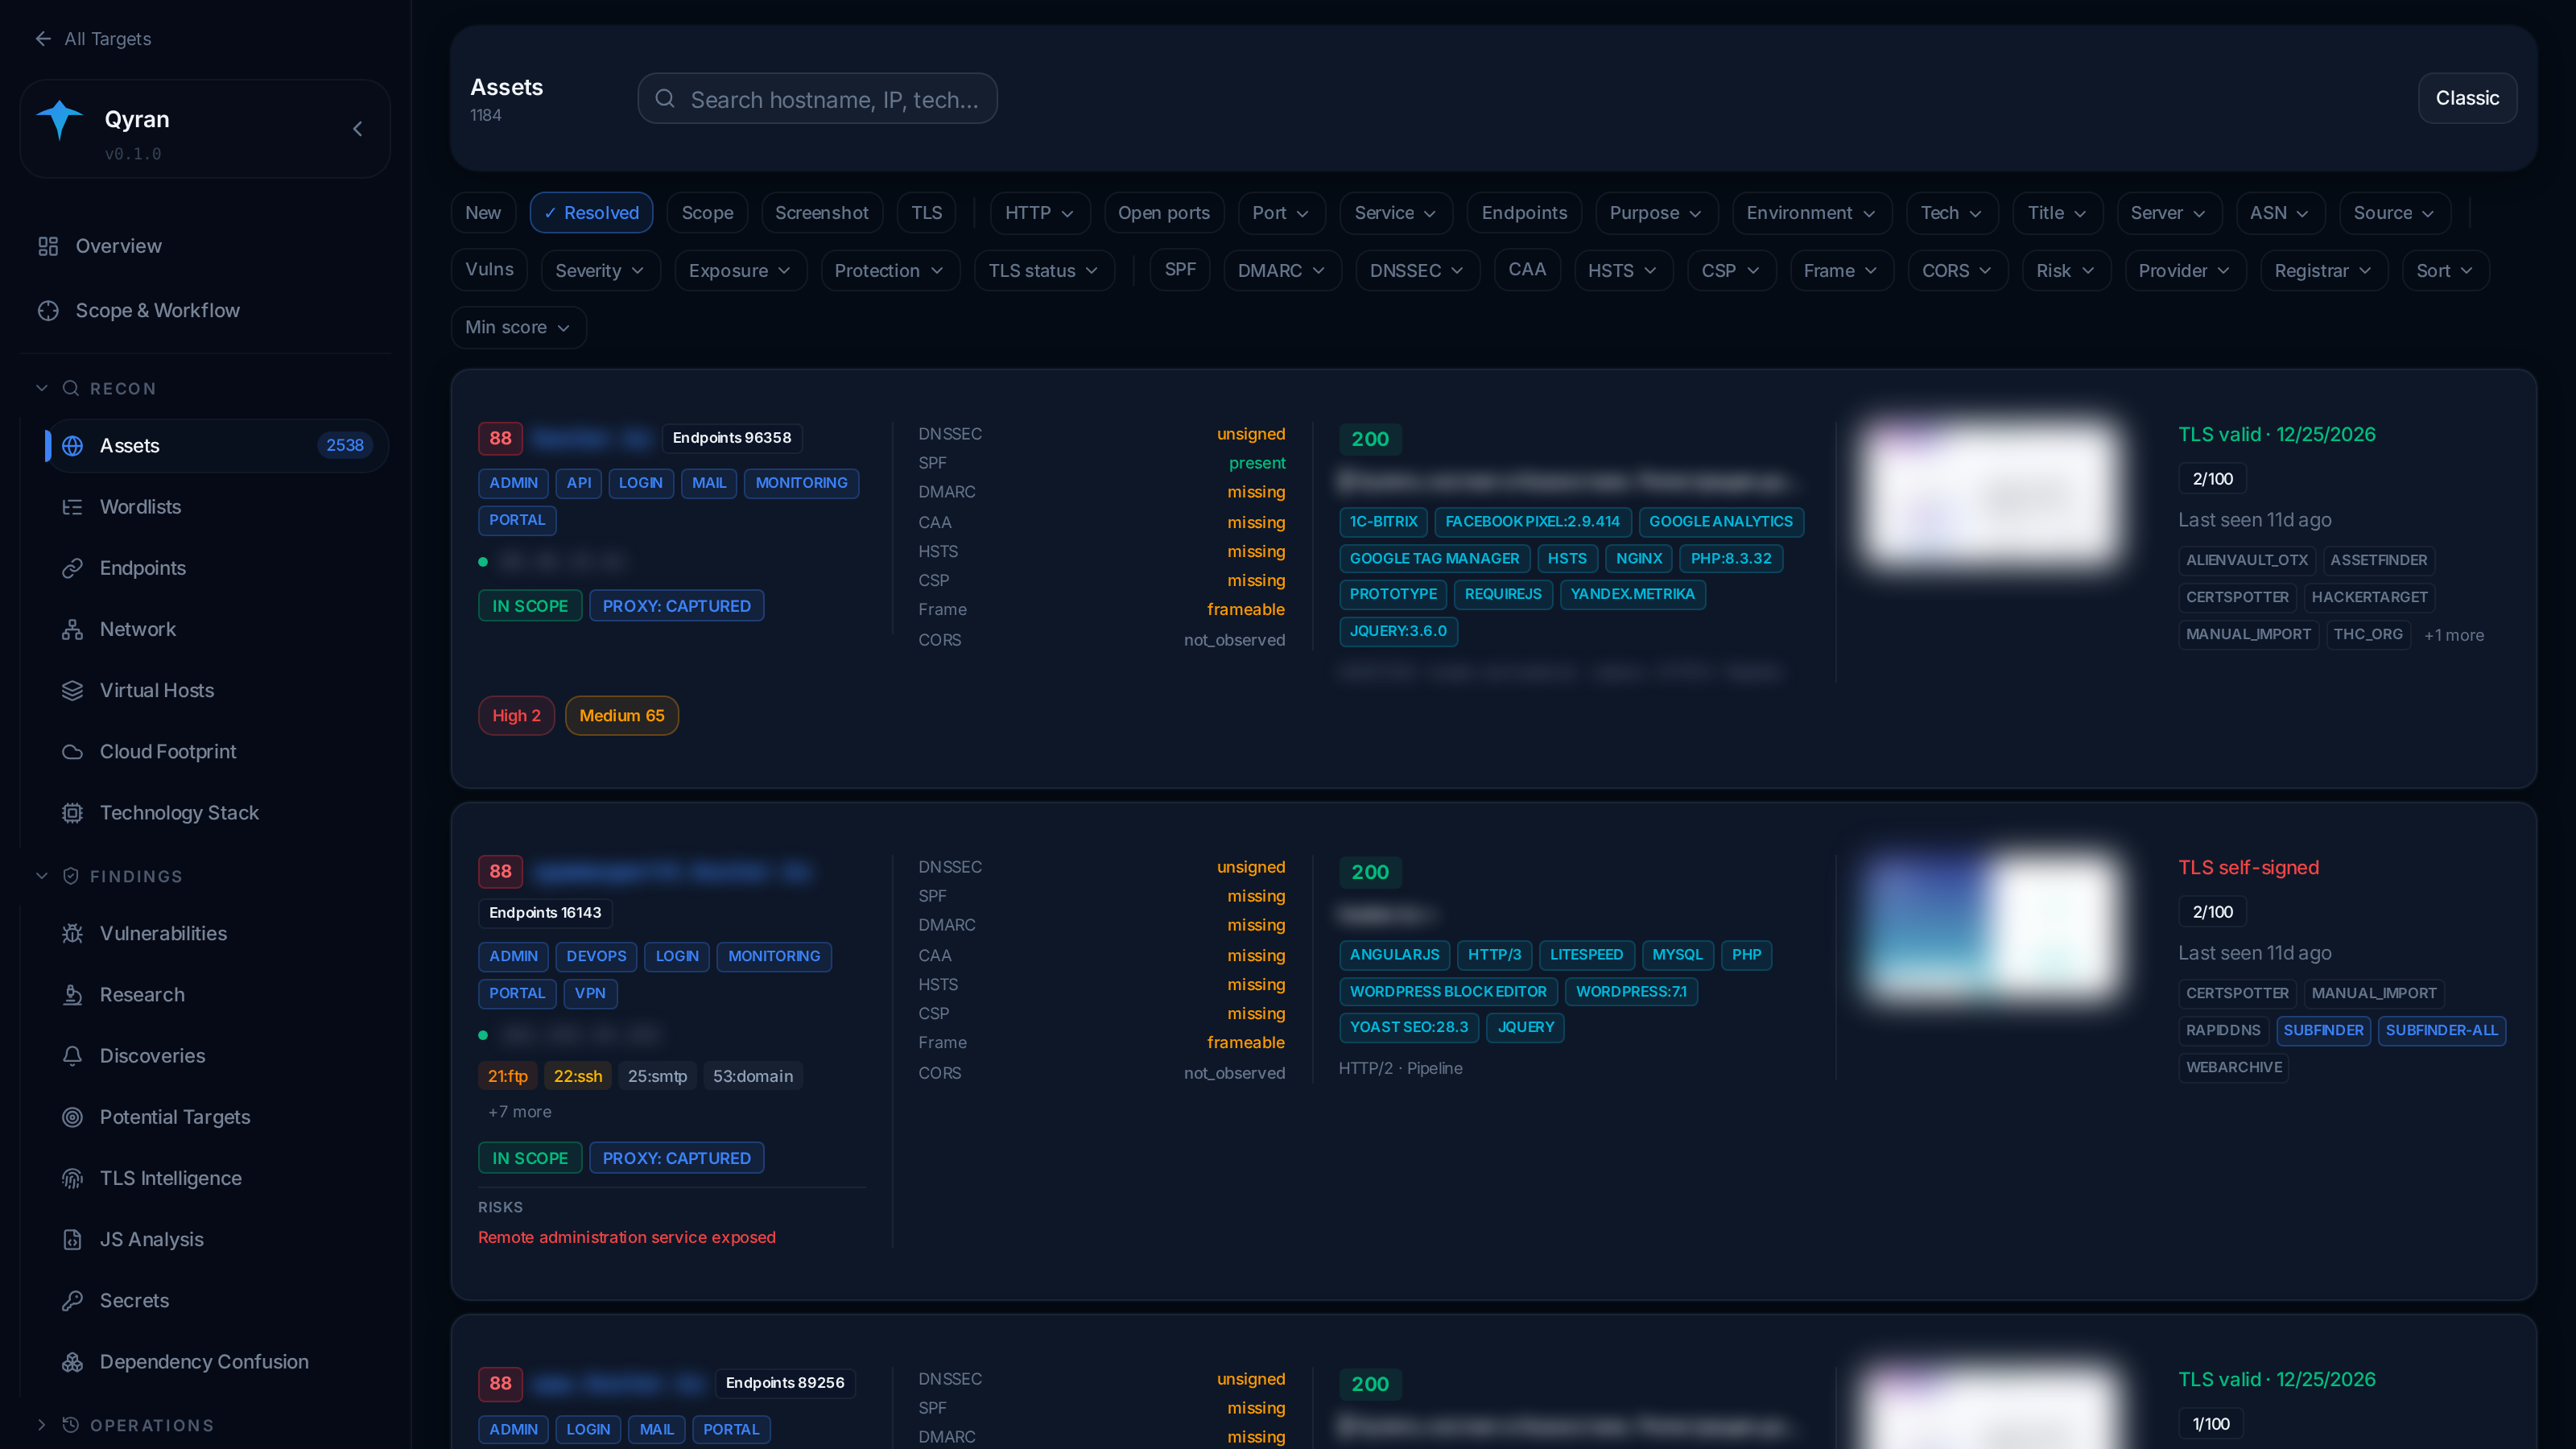
Для каждого хоста собрана полная картина: назначение (admin, API, login, mail, portal, VPN), DNSSEC и почтовые записи (SPF, DMARC, CAA), заголовки безопасности (HSTS, CSP, защита от фрейминга), технологии и версии, открытые порты, TLS, источники, из которых хост был найден, и выявленные риски — например, «наружу открыт сервис удалённого администрирования». Десятки фильтров позволяют быстро найти, скажем, все хосты без HSTS с открытой админкой.
Отдельные представления: Endpoints (всё, что нашёл краулер), Network (IP, порты, версии служб и связанные домены), Virtual Hosts, Cloud Footprint (CDN и облачные провайдеры), Technology Stack (где используется конкретная технология — удобно, когда выходит новая CVE) и TLS Intelligence.
Opportunity score — куда копать в первую очередь
На скриншотах у целей и активов есть цифра от 0 до 100. Это оценка привлекательности для исследователя, и она полностью объяснимая — складывается из трёх ограниченных корзин:
| Корзина | Максимум | Что учитывает |
|---|---|---|
| Чувствительность | 40 | насколько актив «вкусный»: админки, API, базы данных, dev/staging, объём поверхности |
| Экспозиция | 35 | насколько он атакуем прямо сейчас: подтверждённые находки, открытые порты управления и БД, секреты в JS, отсутствие CDN/WAF, риск захвата поддомена |
| Гигиена | 25 | дефекты конфигурации: TLS, заголовки, CORS |
Высокий балл = слабый + доступный + чувствительный актив с подтверждёнными находками. Именно его стоит смотреть первым. Оценка — чистая функция от уже собранных данных, поэтому пересчитывается после каждого скана и всегда показывает, какие сигналы дали балл.
Vulnerabilities — управление находками
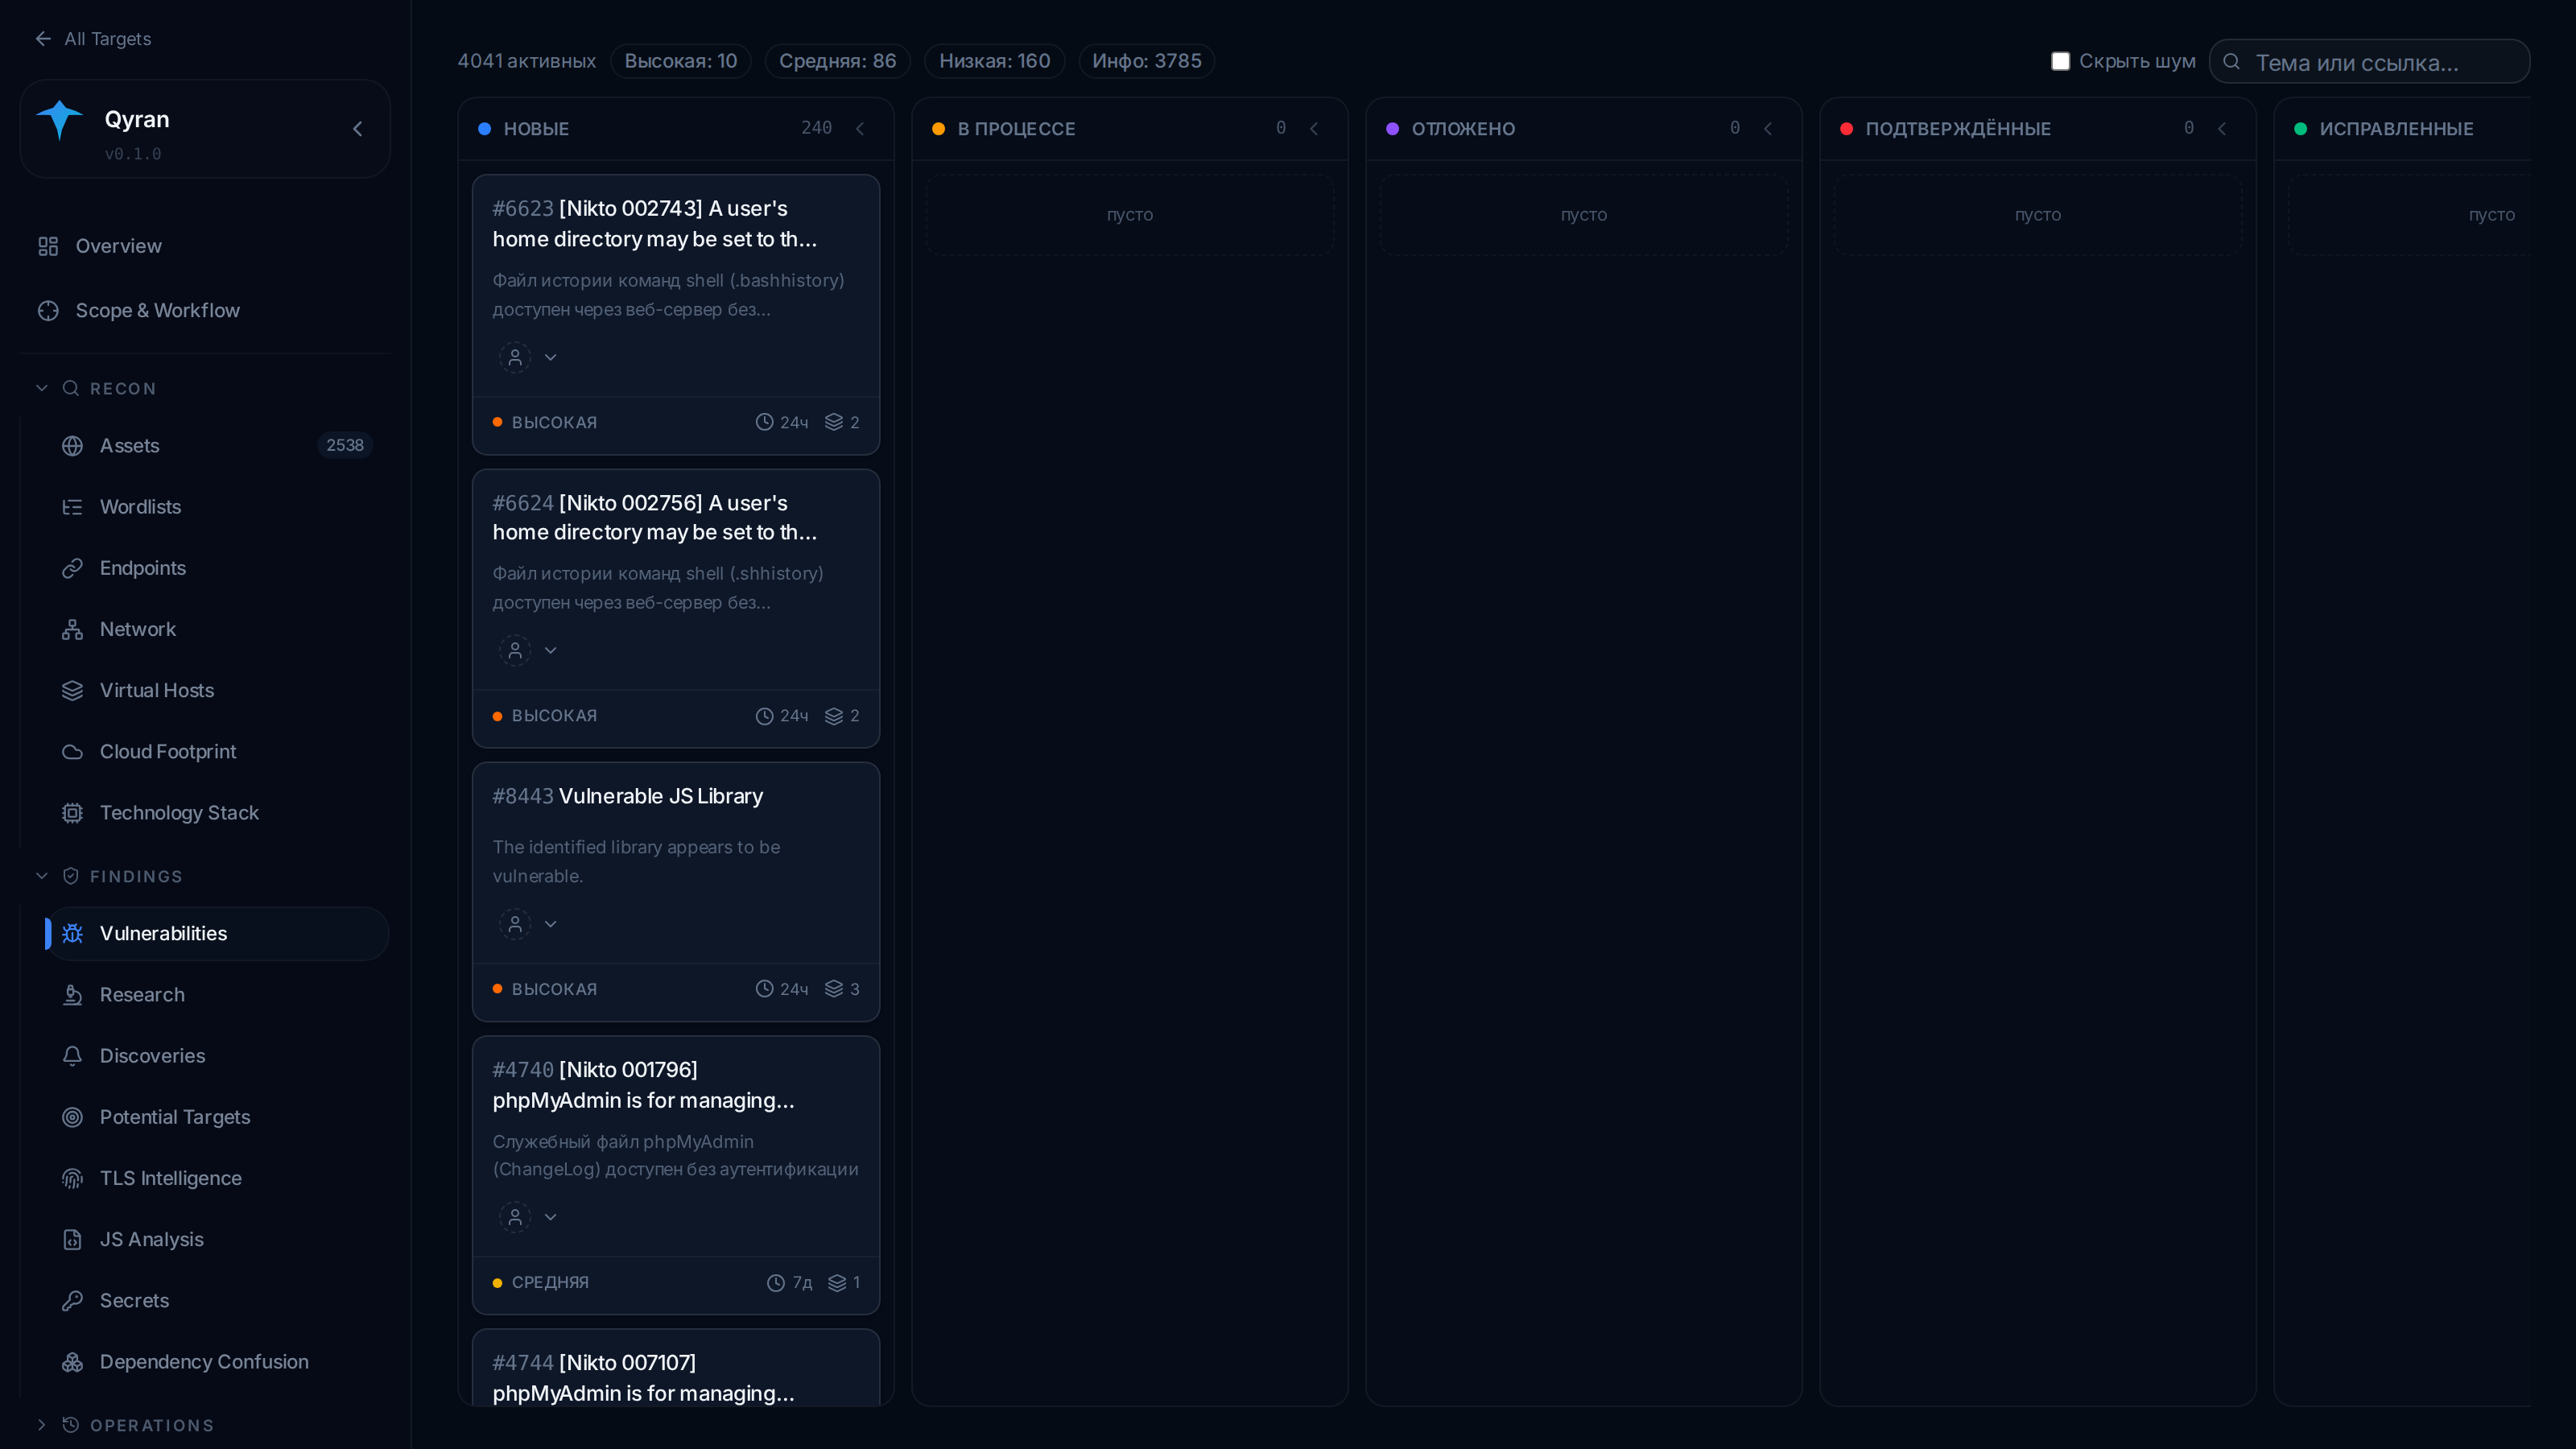
Находки всех сканеров — nuclei, ZAP, OpenVAS, nikto, анализа JS — попадают в один канбан: новые, в процессе, отложенные, подтверждённые, исправленные. Карточки с markdown-описанием, подзадачами, комментариями, вложениями и исполнителями. Есть переключатель «Скрыть шум» — информационные находки не мешают работать с важными.
Discoveries и Potential Targets
Discoveries — лента изменений. В режиме мониторинга панель сравнивает каждый запуск с предыдущим: появился новый поддомен, открылся порт, поменялся ответ сервиса. Если на каком-то поддомене «упал» файрвол и сервис стал доступен извне, это нужно увидеть сразу, а не через месяц.
Potential Targets — активы, которые косвенно связаны с целью (общий IP, сертификат, регистрант), но не сканируются по умолчанию: они могут принадлежать другой компании. Исследователь сам решает, относятся ли они к scope. Сканировать то, на что нет разрешения, нельзя — и панель это поддерживает архитектурно, а не на честном слове.
Свой перехватывающий прокси
Внутри панели есть полноценный перехватывающий прокси в духе Burp и Caido:
- Intercept — остановить запрос, ответ или WebSocket-сообщение, отредактировать и отпустить или отбросить;
- HTTP и WS History — весь захваченный трафик с фильтрацией;
- Replay — коллекции и сессии повторных отправок;
- Scopes и Filters — сохранённые пресеты;
- Sitemap — дерево обойдённого сайта.
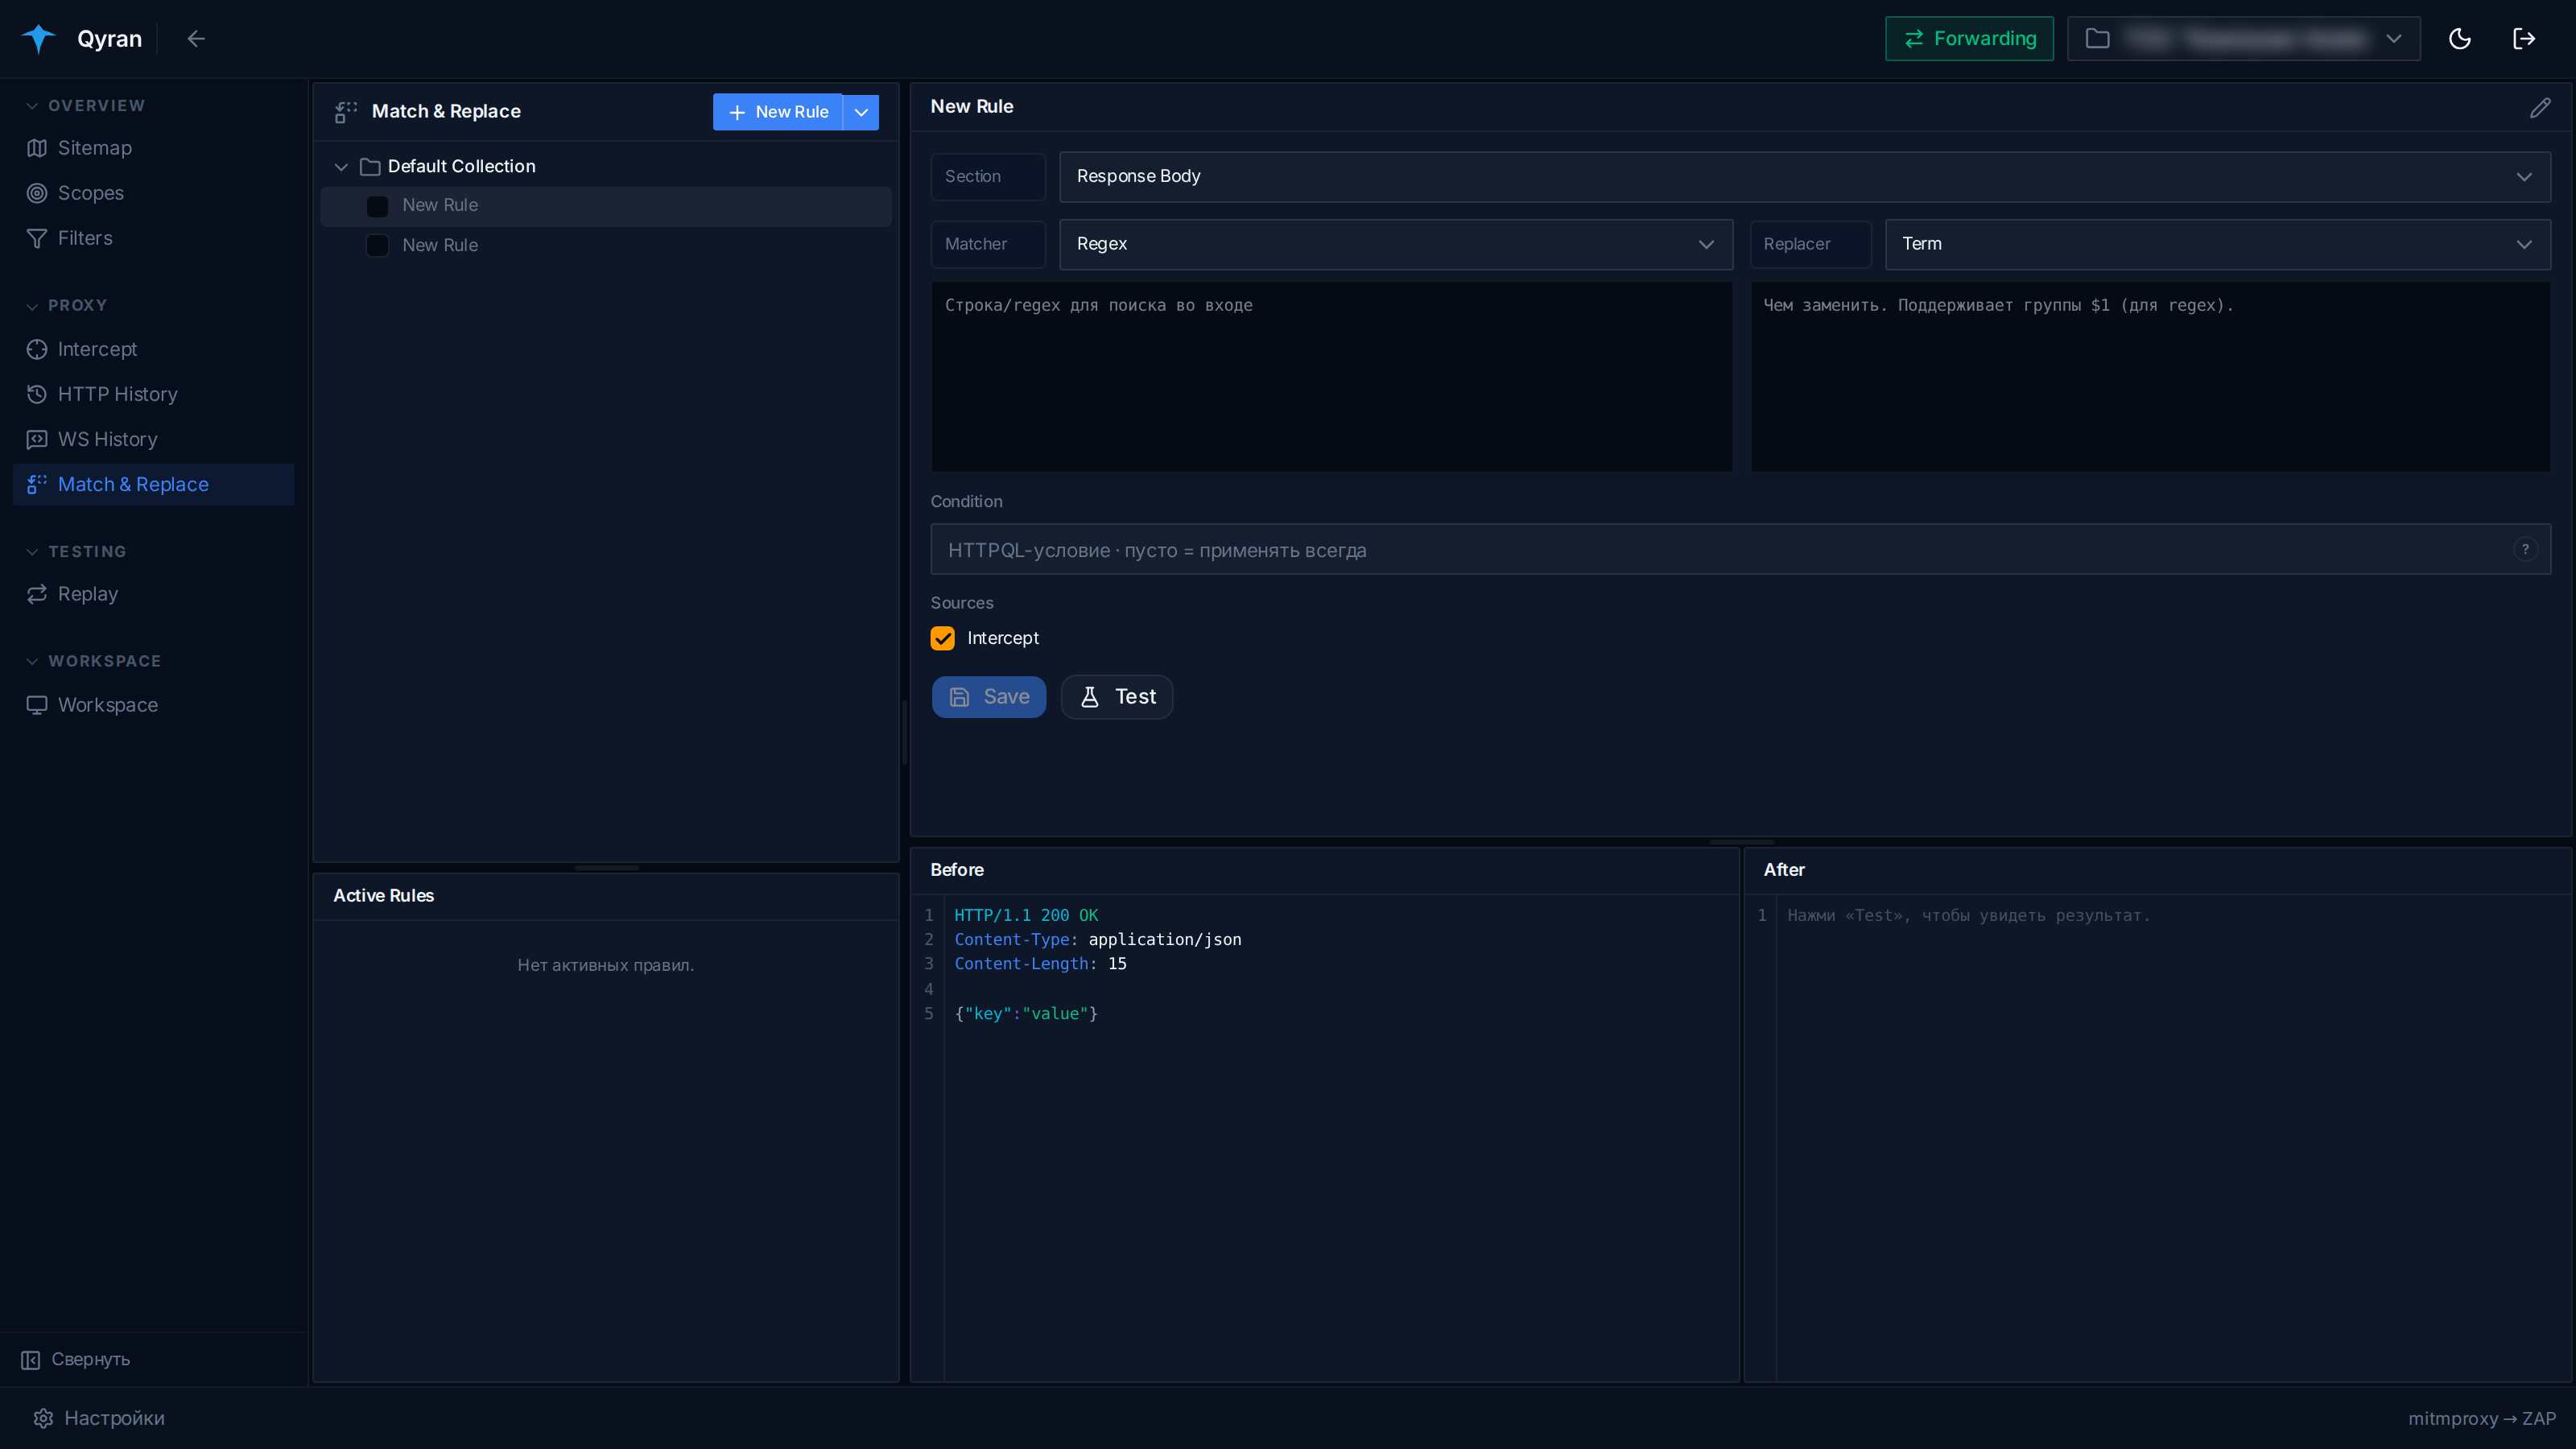
Две вещи я сделал по-своему.
HTTPQL — язык запросов к истории трафика, как в Caido. Вместо десятка галочек пишешь условие вроде resp.code.eq:200 и получаешь ровно то, что нужно. Тот же язык используется как условие в правилах Match & Replace.
Match & Replace на одном движке. Движок правил написан на чистой стандартной библиотеке Python, без зависимостей от приложения. Поэтому один и тот же файл монтируется и в контейнер mitmproxy, и используется бэкендом для кнопки «Test». Что показал тест в панели — ровно то и произойдёт с живым трафиком. Правило — это секция (заголовки или тело запроса/ответа), тип сопоставления (полная замена, подстрока или regex с группами $1) и необязательное HTTPQL-условие.
Технически трафик идёт через mitmproxy, а ZAP подключён как upstream: так весь трафик, который исследователь генерирует руками, параллельно проходит пассивный анализ ZAP.
Шаблоны nuclei
Отдельный раздел — управление шаблонами nuclei. Помимо официальной библиотеки, у панели есть своя структура:
- рабочие шаблоны — черновики, которые я пишу и отлаживаю;
- боевые — проверенные, которые запускаются в сканах;
- URL-шаблоны — для точечных проверок;
- импорт шаблонов из GitHub-репозиториев и форк официальных шаблонов в рабочие для доработки.
Отдельный AI-агент умеет писать шаблоны nuclei под конкретную находку и сразу их запускать — так ручная находка превращается в автоматическую проверку для всего парка целей.
Анализ JavaScript, секреты и Dependency Confusion
Современные приложения прячут половину логики в JavaScript. Отдельный микросервис собирает JS-файлы и source maps, хранит их ревизии, показывает дифф между версиями и извлекает из них эндпоинты и параметры. Новые API-маршруты в свежем бандле — одна из самых недооценённых точек входа.
Secrets ищет утёкшие ключи и токены. Для известных провайдеров есть валидатор: он делает один безопасный запрос только на чтение к API самого провайдера, чтобы понять, жив ли ключ. Запросы уходят только на белый список хостов провайдеров, а пользовательский ввод никогда не подставляется в адрес хоста.
Dependency Confusion вытаскивает из собранного JS имена npm-пакетов и проверяет, существуют ли они в публичном реестре. Если внутренний пакет не занят публично, это потенциальная атака подмены зависимости. Проверка идёт только к реестру npm и базе OSV — сама цель при этом не затрагивается.
Для рендеринга современных JS-приложений, скриншотов и предпросмотра ответов в панель встроен headless-браузер с отдельными профилями.
Отчёты, история и настройки
- Reports — предпросмотр и экспорт отчёта в PDF;
- Scan History — логи и история всех запусков;
- Tool Control — тонкая настройка инструментов прямо из интерфейса: rate limit, потоки, таймауты, заголовки, профили портов;
- Test Accounts — хранилище тестовых учёток для авторизованных проверок.
AI-слой
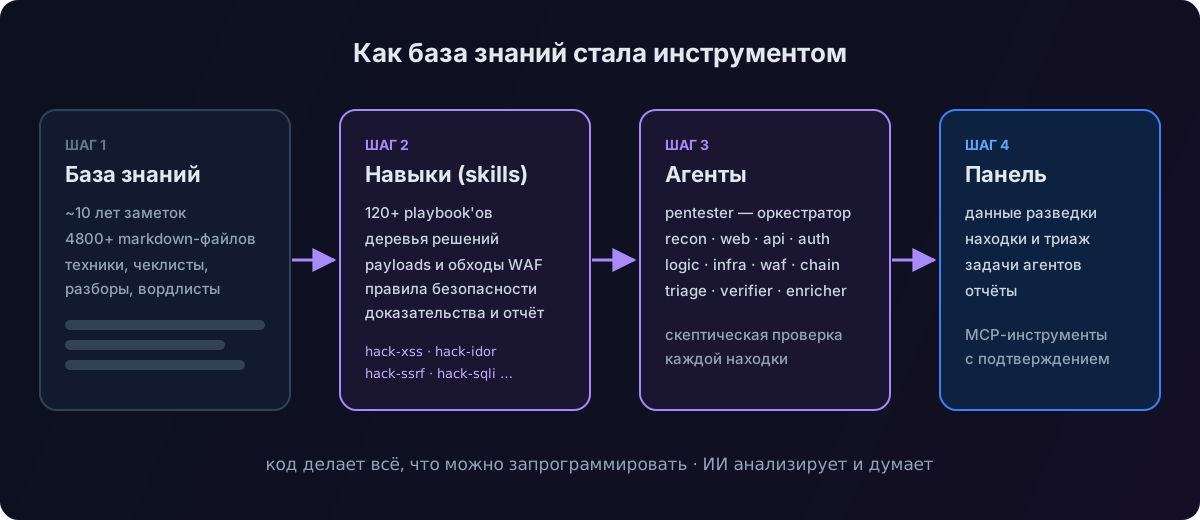
База знаний → навыки
Хранилище Obsidian — 4800+ markdown-заметок — монтируется в контейнеры только на чтение. Из него собрано 120+ навыков, большинство — hack-* по классам уязвимостей и техникам: веб-инъекции, аутентификация и контроль доступа, бизнес-логика, API, Active Directory, облака, мобильные приложения, контейнеры и другие. Навык — это не промпт «найди XSS», а методичка, которую агент подгружает под задачу.
Агенты
32 специализированных агента. Главный — pentester, оркестратор: разведка → делегирование задач → сборка находок. Под ним специалисты по направлениям — разведка, API, веб, аутентификация, бизнес-логика и IDOR, инфраструктура, обход WAF, цепочки атак. И отдельная группа, которая делает результат надёжным:
- triage — разбор и приоритизация находок;
- verifier — скептическая перепроверка: агент, который пытается доказать, что находка ложная;
- enricher — обогащение CVSS, CWE, CVE и рекомендациями по исправлению.
Ещё одна группа агентов занимается развитием самой платформы и базы знаний — от архитектуры и тестов до создания новых навыков.
Автономные смены и контроль
Самое опасное в автономном ИИ — что он сделает что-то не то или сожжёт бюджет. Поэтому у автономной работы жёсткие рамки:
- смены (shifts) — ограниченные по времени и бюджету сессии тестирования; при достижении дедлайна или лимита стоимости смена останавливается и передаёт дела;
- правила безопасности встраиваются в задание каждой смены;
- watchdog следит за автономными агентами и наводит порядок, если что-то пошло не так;
- одобрение действий — инструменты агента подключены через MCP, и потенциально рискованные действия требуют подтверждения. Политика автоодобрения настраивается глобально и для расписаний;
- проверка scope на уровне инструментов — агент не может выйти за разрешённую область;
- журнал покрытия — какие проверки выполнены полностью, частично, провалены или пропущены. Видно не только что найдено, но и что ещё не проверено.
Ответственное использование
Qyran — инструмент для авторизованного тестирования: bug bounty программ в рамках их правил и аудитов по договору. Поэтому в панель встроены ограничения на уровне архитектуры:
- явные In Scope и Out of Scope для каждого проекта;
- косвенно связанные активы попадают в Potential Targets и не сканируются, пока исследователь не примет решение;
- проверки секретов и зависимостей не трогают цель;
- рискованные действия агентов требуют подтверждения.
Что дальше
- больше навыков и агентов-специалистов;
- углубление бесконечной разведки: гипотезы от ИИ, которые конвейер сам проверяет;
- развитие отчётов под форматы bug bounty платформ.
Для меня Qyran — это главный итог многих лет в ИБ: база знаний, которую я собирал со школы, превратилась в работающий инструмент, а рутина разведки — в конвейер, который работает, пока я сплю.
Код проекта закрыт, но я с удовольствием покажу панель вживую — напишите мне. О защитной «сестре» Qyran — панели триажа уязвимостей для SOC — я рассказываю в статье «SOC на Wazuh с нуля».