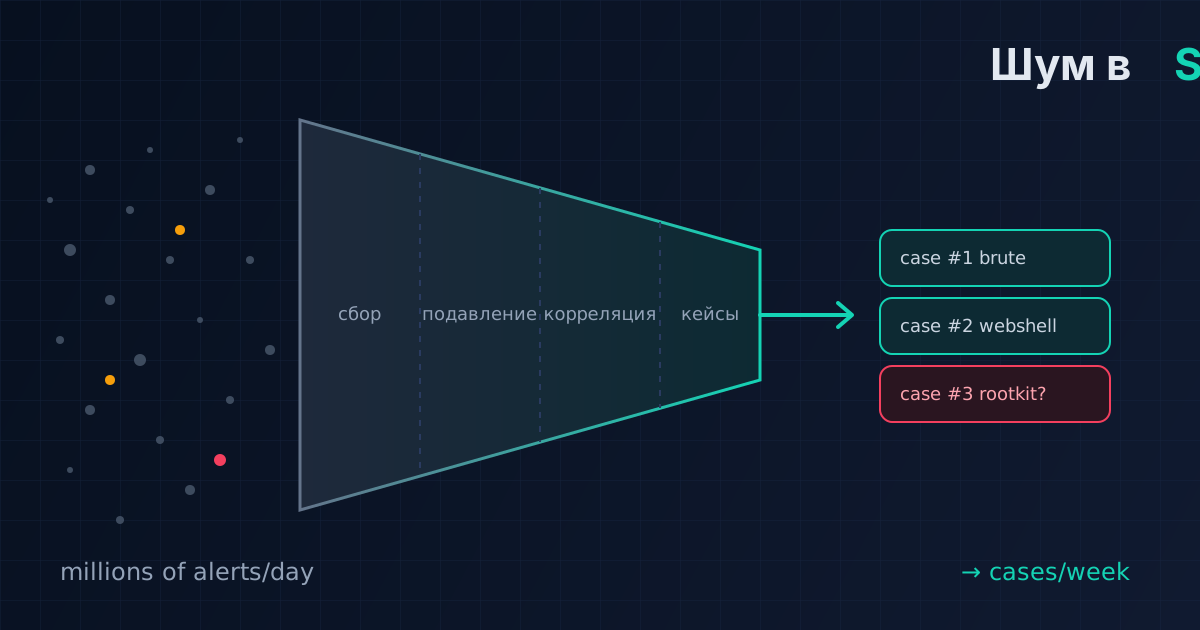
Шум в SIEM: от миллионов алертов к очереди инцидентов
Срез реального SIEM на хостинге: миллионы алертов в сутки, три правила дают почти 90% объёма, а «критичные» алерты почти целиком состоят из шума. Как с этим жить и что настраивать.
Развернуть SIEM — полдела. Через пару месяцев после запуска Wazuh я сделал срез и понял, что смотреть в панель бесполезно: алерты сыпались десятками в секунду, а среди них терялось то, ради чего всё строилось. Эта статья — разбор того среза и модель, по которой я превращаю «пожарный шланг» в очередь инцидентов. Как устроен сам кластер, я писал в статье «SOC на Wazuh с нуля».
Имена серверов, агентов и точные значения не приводятся — только доли и порядки величин. Номера правил — стандартные правила Wazuh.
Масштаб проблемы
Картина на момент среза:
- миллионы алертов в сутки — в среднем больше 60 в секунду;
- более 100 миллионов алерт-документов в индексе за несколько месяцев;
- распределение крайне неравномерное: один сервер давал около 22% всех алертов, а пятнадцать самых шумных агентов — больше половины.
Кластер при этом был здоров: нагрузка равномерно распределялась по рабочим узлам, шарды на месте. Проблема была не в инфраструктуре, а в том, что именно мы превращаем в алерты.
Кто шумит: три правила — 90% объёма
Самое полезное, что можно сделать с шумным SIEM, — посчитать алерты по правилам. У меня вышло так:
| Правило | Что это | Доля за неделю |
|---|---|---|
31101 | Ответ веб-сервера с кодом 4xx | ~37% |
550 | Изменилась контрольная сумма файла (FIM) | ~36% |
31410 | Предупреждение PHP | ~15% |
| остальные | сотни других правил | ~12% |
Два правила — около трёх четвертей всего объёма, три — почти 90%. По декодерам то же самое: подавляющая часть приходит из логов доступа веб-серверов и из контроля целостности файлов.
Почему так происходит на хостинге:
- Логи доступа. На shared-хостинге тысячи сайтов, которые круглосуточно сканируют боты. Каждый 404 от сканера — алерт.
- Контроль целостности (FIM). Сайты постоянно пишут кэш, сессии, логи, загрузки. Если FIM смотрит на эти каталоги, каждое сохранение кэша — «изменилась контрольная сумма».
- PHP-предупреждения. Старые CMS и плагины сыплют warning’ами в лог на каждый запрос.
«Смотрите только критичные» — не работает
Первая идея — фильтровать по уровню и смотреть только level >= 10. Проверяем:
- алертов уровня 10+ — сотни тысяч в неделю, больше двухсот тысяч в сутки;
- около 99% из них — два корреляционных веб-правила: «много ошибок 4xx с одного IP» (
31151) и «много POST-запросов за короткое время, вероятно бот» (31533).
То есть корреляция поверх шума даёт коррелированный шум. Уровень критичности в стандартных правилах не учитывает контекст: для shared-хостинга сканирование — это фон, а не инцидент.
При этом среди того же среза были и действительно важные сигналы, которые просто тонули:
- нехватка памяти и заполненная файловая система на серверах;
- переполнение очереди событий агента — агент не успевает отправлять события и может их терять;
- подозрения на rootkit, попытки SQL-инъекций и XSS, Shellshock;
- серии неудачных SMTP-аутентификаций.
Именно ради них и нужен SIEM, и именно их нужно «достать» из шума.
Модель: пять слоёв
Отправлять все алерты в систему управления инцидентами нельзя — получатся миллионы «кейсов». Обогащать все алерты (GeoIP, репутация, контекст) тоже нельзя — дорого и бессмысленно. Поэтому модель многоуровневая.
1. Сбор и нормализация
Источники делятся по типу, и для каждого фиксируется ожидаемый «фон»:
- веб-хостинг, базы данных, внутренние приложения;
- сетевое оборудование и файрволы;
- антивирус на рабочих станциях;
- рабочие станции и серверы инфраструктуры.
В Wazuh это удобно делать группами агентов: у каждой группы свой agent.conf — что собирать и что игнорировать.
2. Подавление шума
Здесь основной выигрыш. Что сделать в первую очередь:
Исключить из FIM каталоги, которые меняются постоянно — кэш, временные файлы, сессии, логи:
<syscheck>
  <ignore type="sregex">/cache/|/tmp/|/sessions?/|\.log$</ignore>
</syscheck>
Контроль целостности ценен для кода, конфигов и системных файлов, а не для каталога, куда CMS пишет кэш каждые пять секунд.
Понизить до нулевого уровня малоценные правила — дочерним правилом в local_rules.xml:
<group name="local,noise,">
  <rule id="100200" level="0">
    <if_sid>31410</if_sid>
    <description>PHP warnings на хостинге: не алертим</description>
  </rule>
</group>
События уровня 0 не становятся алертами. Если сырые события нужны для расследований, их можно сохранять в архив, не превращая в алерты.
Аккуратнее с веб-правилами. Если «заглушить» базовое правило 4xx целиком, перестанут срабатывать и корреляции, построенные на нём. Поэтому для веб-хостинга лучше отдельная политика: подавлять одиночные ошибки, но оставлять признаки реальной атаки — SQL-инъекции, XSS, Shellshock, обход каталогов, успешные ответы на подозрительные запросы.
3. Корреляция в «кандидаты в инциденты»
Алерт становится кандидатом только при сочетании условий, а не сам по себе. Примеры:
- Аутентификация: серия неудач + необычная учётная запись + внешний источник + критичный актив.
- Веб-атаки: несколько типов атак с одного IP + успешный ответ (200/500) + защищаемое приложение, а не случайный клиентский сайт.
- FIM: изменение в критичном пути + неожиданный процесс или пользователь + продуктивный сервер.
- Здоровье системы: нехватка памяти, заполненный диск, переполнение очереди агента — на критичном активе.
- Рабочие станции: антивирус обнаружил угрозу и не вылечил её автоматически, повторные срабатывания, признаки движения по сети.
4. Обогащение
Только для кандидатов:
- критичность актива и владелец сервиса;
- группа и роль сервера;
- GeoIP, ASN и репутация IP;
- известные уязвимости на этом хосте;
- связанные события за последние часы и прошлые кейсы.
5. Кейсы
В систему реагирования (у меня в планах — DFIR-IRIS) попадает только то, что прошло все фильтры. Цель — десятки осмысленных кейсов в неделю, а не сотни тысяч алертов.
Не забывайте про здоровье самого SIEM
Один из самых недооценённых сигналов в срезе — переполнение очереди событий агента. Если агент на шумном сервере не успевает отправлять события, он начинает их терять — и вместе с шумом может потерять как раз важное событие. Поэтому снижение шума — это не только про удобство аналитика, но и про надёжность сбора.
Как сделать такой срез у себя
Достаточно нескольких агрегаций по индексу алертов (через панель или запросами к OpenSearch):
- количество алертов за сутки, неделю, месяц — динамика;
- распределение по
rule.level; - топ-20 правил по количеству;
- топ-20 агентов и их главные правила;
- топ декодеров и источников (
location); - отдельно — все правила уровня 10+ с количеством.
Уже по первым трём пунктам обычно видно, куда уходят 80–90% объёма.
Итоги
- Шум в SIEM почти всегда сконцентрирован в нескольких правилах — найдите их, и вы решите большую часть проблемы.
- Фильтр по уровню критичности не заменяет настройку: корреляция поверх шума даёт коррелированный шум.
- Начинайте с FIM-исключений для кэшей и логов и с понижения малоценных правил — это самый быстрый выигрыш.
- В кейсы должно попадать только то, что прошло подавление, корреляцию и обогащение.
- Настройка шума — постоянный процесс: делайте срез регулярно и сравнивайте с предыдущим.