Второй мозг с AI: Claude, NotebookLM и Obsidian в одной связке
Пять тысяч заметок — это много, но читать их всё равно приходится мне. Связка из агента, NotebookLM и Obsidian превращает хранилище в «второй мозг», который сам разбирает входящие, помнит контекст и отвечает по моей базе.
О том, как устроено само хранилище, я подробно писал в статье «Как я организовал заметки в Obsidian: PARA по-русски». Здесь — следующий шаг: как к нему подключены AI-инструменты и какую работу они на себя забрали.
Проблема: записывать легко, разбирать — нет
Записывать в Obsidian я привык давно. Узкое место было в другом:
- входящие копятся быстрее, чем я их разбираю;
- заметки разного возраста оформлены по-разному;
- чтобы ответить на вопрос «как я это уже делал», нужно помнить, где лежит заметка;
- каждый новый чат с AI начинается с нуля — объяснять контекст приходится заново.
Три роли
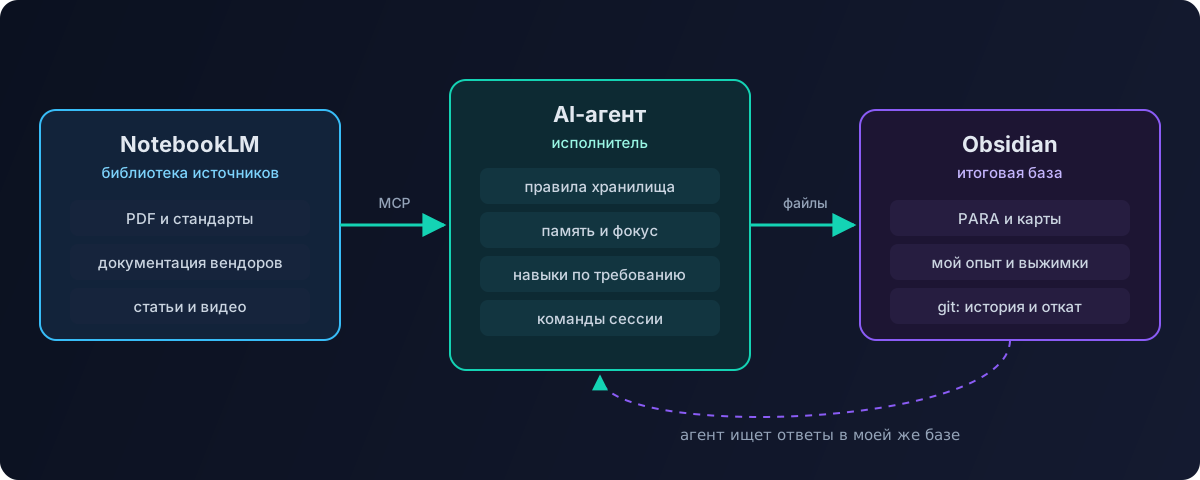
Решение — разделить работу между инструментами, каждому дав одну роль.
| Инструмент | Роль | Что делает |
|---|---|---|
| NotebookLM | библиотека источников | хранит сырые материалы — PDF, документацию, длинные статьи, видео; отвечает строго по ним, со ссылками |
| AI-агент (Claude Code, opencode) | исполнитель | читает и пишет файлы хранилища, разбирает входящие, сводит источники в заметки |
| Obsidian | итоговая база | только проверенное и оформленное знание в моей структуре |
Ключевой принцип: сырое и обработанное не смешиваются. Двухсотстраничный стандарт или документация вендора живут в NotebookLM — там удобно задавать вопросы по первоисточнику. В Obsidian попадает только выжимка: «что из этого нужно мне и как я это применил».
Агент работает прямо с файлами
Хранилище Obsidian — это просто папка markdown-файлов. Агенту не нужен никакой API: он открывает папку как проект и работает с файлами напрямую. Для внешних источников — например, NotebookLM или браузера — подключаются MCP-серверы, стандартный способ дать агенту инструменты.
Чтобы агент не превратил базу в мусорку, в корне хранилища лежит его конфигурация.
Правила хранилища
Файл инструкций, который агент читает в начале каждой сессии: структура папок PARA, система тегов, формат карт, куда класть заметки разных типов и чего делать нельзя — например, удалять заметки или трогать архив без подтверждения.
Память
Агент не помнит прошлые сессии, поэтому память — это файлы:
- долговременная память — короткий файл с ключевыми фактами: над чем работаю, какие решения приняты, какие соглашения действуют. У него жёсткий лимит размера — несколько тысяч символов. Без лимита память раздувается и начинает стоить дорого в каждом запросе;
- текущий фокус — над чем я работаю на этой неделе;
- итоги сессий — после каждой сессии агент пишет короткую сводку: что сделано, что решено, что осталось.
Команда начала сессии подгружает память и фокус, команда завершения — пишет итог и обновляет память. Новый чат больше не начинается с нуля.
Навыки
Навык (skill) — это инструкция под конкретный тип задачи, которую агент подгружает только когда она нужна. У меня есть два типа навыков:
- служебные — нормализация заметок, работа с хранилищем, синхронизация памяти, создание новых навыков;
- предметные — то, что я делаю на работе: bug bounty, аудит безопасности серверов, советник по Active Directory, советник по кластеру Wazuh.
Предметные навыки опираются на мою же базу: советник по AD знает мои заметки по CIS Benchmark и моему внедрению, поэтому отвечает в контексте моей инфраструктуры, а не общими словами из интернета.
Конвейер разбора входящих
Самая полезная автоматизация — разбор входящих.
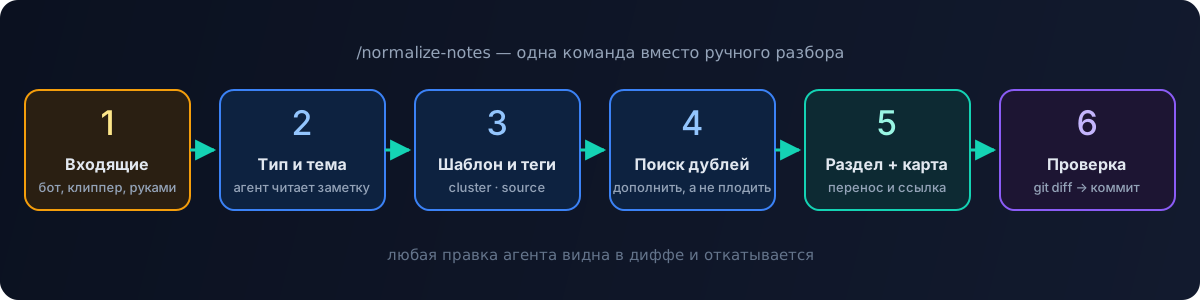
- Заметка попадает во Входящие — из Telegram-бота, веб-клиппера или руками.
- Команда нормализации: агент читает заметку, определяет тип и тему.
- Приводит к шаблону: заголовок, свойства, теги
cluster/…иsource/…. - Ищет похожие заметки — дополнить существующую лучше, чем плодить дубль.
- Переносит в нужный раздел и добавляет ссылку в карту раздела.
- Я просматриваю изменения через git-дифф и подтверждаю.
Шестой пункт важен: хранилище лежит в git, поэтому любую правку агента можно посмотреть и откатить. Агенту я доверяю ровно настолько, насколько могу проверить и отменить его работу.
Что работает, а что нет
Работает отлично:
- нормализация и раскладка входящих — экономит часы в неделю;
- поиск «как я это уже делал» по всей базе;
- сводка нескольких заметок в одну структурированную;
- подготовка черновиков — включая статьи этого блога, которые выросли из заметок.
Работает плохо или требует контроля:
- агент склонен «улучшать» формулировки — для личных записей это лишнее, приходится ограничивать правилами;
- без лимита память и правила разрастаются, и каждый запрос дорожает;
- приватные заметки нельзя отдавать облачной модели — для них есть локальная нейросеть.
О деньгах — отдельно: как не тратить на агентов лишнего, я разбирал в статье «Как экономить на AI-агентах».
Итог
«Второй мозг» — это не одна волшебная программа, а разделение ролей:
- NotebookLM — помнит источники;
- агент — делает рутину по правилам и навыкам;
- Obsidian — хранит знание в моей структуре;
- git — гарантирует, что ничего не потеряется.
Сами по себе инструменты не делают базу знаний полезной. Полезной её делает структура — и регулярность, которую теперь поддерживает агент.